من البيانات الحيّة إلى الاستعادة: ماذا يحدث فعلياً داخل Backup as a Service؟
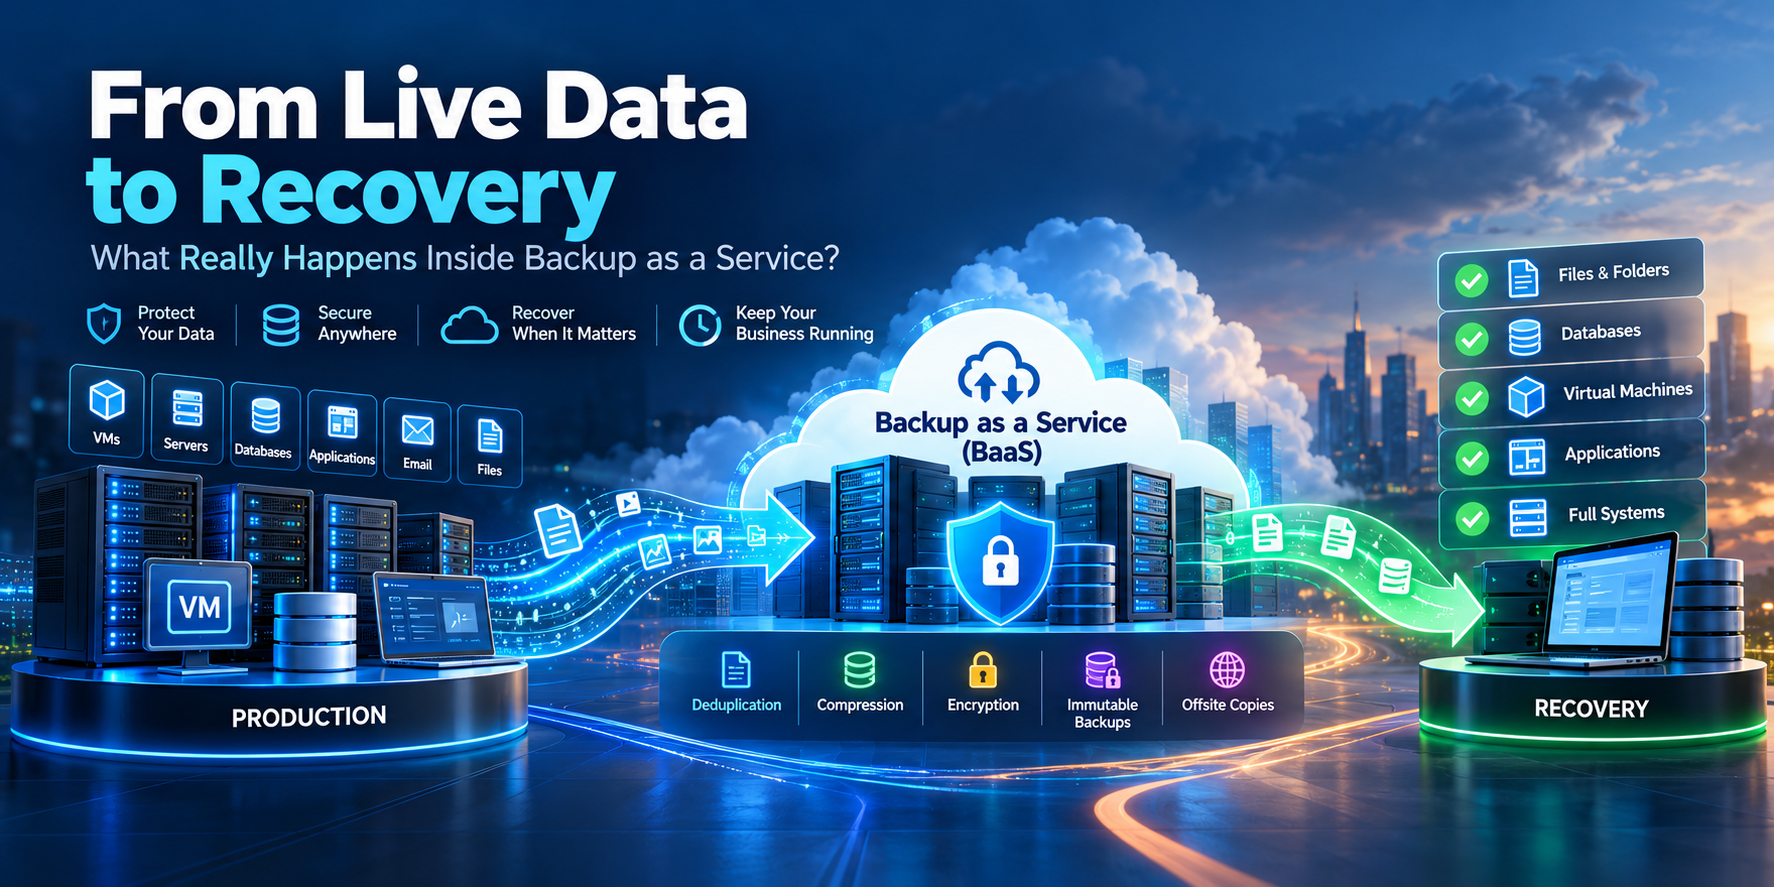
في بيئات الأعمال الحديثة، لم تعد البيانات مجرد ملفات يتم الاحتفاظ بها داخل خادم أو وحدة تخزين، بل أصبحت جزءاً أساسياً من تشغيل المؤسسة نفسها. قواعد البيانات، والأنظمة المالية، والبريد الإلكتروني، والتطبيقات، والـ Virtual Machines جميعها تعتمد على بيانات تتغير باستمرار وتزداد حجماً يوماً بعد يوم. ومع هذا النمو، أصبحت حماية تلك البيانات أكثر تعقيداً من مجرد إنشاء نسخة احتياطية في نهاية اليوم.
لسنوات طويلة، اعتمدت المؤسسات على حلول Backup تقليدية داخليةBackup Server ، وأقراص تخزين إضافية، وأشرطة يتم نقلها إلى مواقع خارجية، إلى جانب فرق تقنية مسؤولة عن متابعة السعة، وفشل مهام النسخ، والصيانة، والاستبدال الدوري للـHardware. لكن كلما توسعت البيئة، ارتفعت معها التكلفة والتعقيد. وما كان مناسباً لحماية بضعة Servers قد يصبح عبئاً عندما تتحول البيئة إلى عشرات أو مئات الأنظمة وTerabytes من البيانات التي تحتاج إلى الحماية باستمرار.
من هنا ظهر مفهوم Backup as a Service – BaaS كطريقة مختلفة للتعامل مع حماية البيانات. فبدلاً من أن تتحمل المؤسسة وحدها مسؤولية بناء وتشغيل وصيانة بنية النسخ الاحتياطي بالكامل، يتم تقديم هذه القدرات كخدمة من خلال مزود متخصص.
لكن القيمة الحقيقية لـBaaS لا تكمن فقط في نقل النسخة الاحتياطية إلى Cloud. فمزود الخدمة يستطيع أيضاً تولي أجزاء كبيرة من دورة حياة Backup، مثل إدارة البنية التحتية، وتوسعة السعة، والمراقبة، والصيانة، والاحتفاظ بالنسخ، وتجهيز البيانات للاستعادة. وبدلاً من أن ينشغل فريق تقنية المعلومات بإدارة Storage أو تبديل Backup Media أو معالجة بنية تحتية قديمة، يستطيع التركيز على الأنظمة التي تدعم الأعمال نفسها.
ولهذا تتجه المؤسسات إلى BaaS خصوصاً عندما تبدأ أنظمة النسخ الاحتياطي التقليدية في الوصول إلى حدودها: حجم البيانات يزداد، وBackup تصبح أطول، والبنية المحلية تحتاج إلى توسعات مكلفة، بينما تزداد في الوقت نفسه الحاجة إلى نسخة Offsite تستطيع المؤسسة الوصول إليها إذا تعرض الموقع الرئيسي لعطل أو كارثة أو هجوم سيبراني.
وهنا يظهر السؤال الأهم:
ماذا يحدث فعلياً لبياناتك منذ اللحظة التي تغادر فيها بيئة Production وحتى تصبح Recovery Point آمنة وقابلة للاستعادة؟
وكيف تتحول هذه النسخة لاحقاً، في يوم الحادث، من بيانات مخزنة داخل Cloud إلى Server أو Database أو Application تعمل من جديد؟
الـVirtual Machine لم تُنسخ كملف واحد، وقاعدة البيانات لم تُلتقط بصورة عشوائية، والـCloud Provider لا يأخذ البيانات ويلقيها ببساطة داخل مساحة Storage ضخمة. قبل أن تتحول بيانات Production الحيّة إلى Recovery Point يمكن الاعتماد عليها، تمر عبر سلسلة دقيقة من العمليات: تحديد ما يجب حمايته، تثبيت حالة البيانات، اكتشاف ما تغير، نقل البيانات، إزالة التكرار، الضغط، التشفير، إنشاء Metadata، تطبيق Retention، ثم حماية النسخة نفسها من الخطأ البشري والهجمات السيبرانية.
والأهم أن الرحلة لا تنتهي عندما تصل البيانات إلى Backup Repository.
عندما يحدث العطل، يجب أن تسير العملية كاملة في الاتجاه المعاكس: العثور على النسخة المناسبة، التحقق من سلامتها، إعادة بناء البيانات، استعادتها، ثم التأكد من أن الخدمة نفسها عادت للعمل.
الرحلة الأولى: من Production إلى Recovery Point موثوقة#
عندما تبدأ مهمة Backup، فإن البيانات التي تريد حمايتها لا تكون ساكنة.
المستخدمون يعدّلون الملفات. قواعد البيانات تستقبل Transactions. التطبيقات تكتب إلى الأقراص. والـVirtual Machines تنفذ آلاف عمليات القراءة والكتابة. أي أننا نحاول تصوير شيء يتحرك باستمرار.
ومن هنا يبدأ التحدي الحقيقي:
كيف تنشئ نسخة صحيحة من نظام لا يتوقف عن التغيير؟#
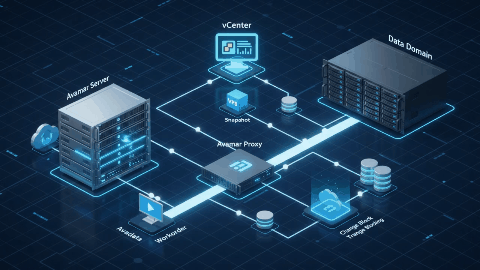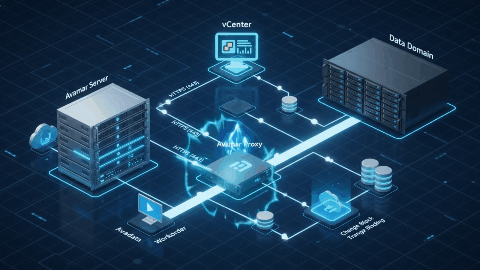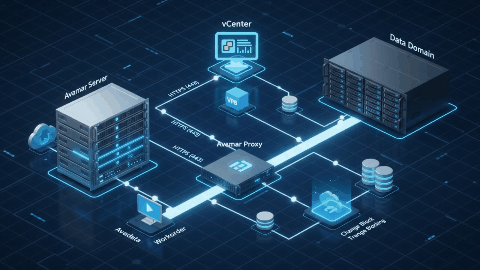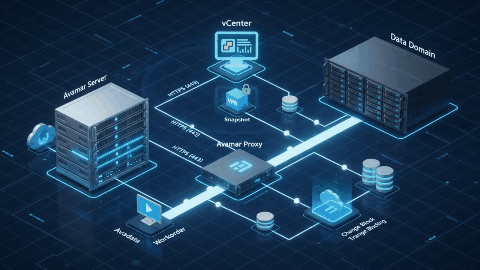
قبل أول Byte: ما الذي نحميه فعلياً؟#
أولى مراحل Backup لا تتعلق بالتخزين، بل بالتعرف على الـWorkload، قد يكون المصدر Virtual Machine، أو Physical Server، أو Database، أو File Server، أو Email Platform، أو Business Application، أو Endpoint.، والفرق بينها ليس شكلياً.
وهنا تتشكل البنية الأساسية لخدمة BaaS: آلية لالتقاط البيانات، Repository لحفظ النسخ، منصة لإدارة السياسات والمراقبة، ثم Recovery Services تعيد البيانات عندما تحتاجها المؤسسة.
تجميد لحظة داخل نظام لا يتوقف#
لنفترض أن لدينا Database نشطة. في اللحظة التي يبدأ فيها Backup قد تكون بعض البيانات مكتوبة بالفعل إلى Disk، بينما توجد أجزاء أخرى في Memory، وهناك Transactions لم تكتمل بعد.
إذا قامت المنصة بقراءة الملفات مباشرة في تلك اللحظة، فقد تحصل على نسخة موجودة فعلياً، لكنها ليست بالضرورة نسخة منطقية سليمة.
وهنا يأتي مفهوم:
Application Consistency
تقوم الفكرة على الوصول إلى لحظة يمكن الاعتماد عليها قبل أخذ النسخة. قد يتم إجبار التطبيق على كتابة البيانات المعلقة، واستكمال أو تعليق بعض عمليات الكتابة لفترة قصيرة، وإنشاء نقطة ثابتة، ثم السماح للتطبيق بمواصلة العمل.
يمكن تبسيط العملية هكذا:
Application Running → Flush Pending Data → Consistent Point-in-Time State → Resume
وهنا يظهر الفرق بين:
Crash-Consistent Backup، التي تشبه تقريباً حالة النظام بعد انقطاع كهربائي مفاجئ،
وبين:
Application-Consistent Backup، التي تحاول التأكد من أن التطبيق نفسه في حالة يمكن استعادتها بصورة صحيحة.
لذلك فإن سؤال كيف يتم التعامل مع Application Consistency؟ يعد من الأسئلة المهمة عند تقييم أي خدمة Backup، خصوصاً لقواعد البيانات والتطبيقات الحساسة.
عندما تصبح الشبكة جزءاً من الـBackup#
بعد تحديد البيانات، يجب نقلها إلى Backup Repository.
وهنا تتحول Backup إلى مشكلة Network بقدر ما هي مشكلة Storage.
يتأثر الأداء بـ:
كمية البيانات المتغيرة.
Bandwidth.
Latency.
عدد Jobs التي تعمل في الوقت نفسه.
المسافة بين المصدر وBackup Infrastructure.
وهذه النقطة تصبح أكثر أهمية في Cloud Backup وOffsite Backup.
تقليل البيانات التي يجب إرسالها عبر Incremental Backup وDeduplication وCompression يساعد كثيراً، ولهذا تعتمد سرعة Recovery أيضاً على Bandwidth وحجم البيانات وStorage Performance وطريقة الاستعادة نفسها.
Deduplication: لماذا نخزن الشيء نفسه مئات المرات؟#
تخيل بيئة تحتوي على مئات الـVirtual Machines.، الكثير منها يحتوي على أجزاء متشابهة من أنظمة التشغيل والتطبيقات والملفات، إذا خزننا كل شيء كما هو، سنخزن البيانات نفسها مرات عديدة. وهنا تدخل Deduplication.
تقوم المنصة بالتعرف على البيانات التي رأتها من قبل.
إذا كانت البيانات موجودة، لا تحتاج إلى تخزين نسخة ثانية منها؛ يكفي Reference يشير إلى البيانات الموجودة. أما البيانات الجديدة فتُحفظ.
الفكرة ببساطة:
Duplicate Data → Reference Existing Data
Unique Data → Store
ثم تستطيع المنصة ضغط البيانات الفريدة باستخدام Compression لتقليل الحجم أكثر.
لذلك لا يُقاس نجاح منصة Backup فقط بالسعة الخام التي تمتلكها، بل أيضاً بمدى كفاءة استخدامها لهذه السعة. وتظهر Deduplication وLong-Term Retention وInstant Restore وMonitoring وSearch كقدرات أساسية في منصات الحماية المتكاملة.
من حماية البيانات إلى حماية الـBackup نفسها Encryption#
النسخة الاحتياطية قد تحتوي على قواعد بيانات العملاء، الملفات المالية، البريد الإلكتروني، إعدادات الأنظمة، وحتى صورة شبه كاملة من البنية التقنية للمؤسسة.
ولهذا توجد حالتان يجب حمايتهما.
Data in Transit أثناء انتقال البيانات عبر الشبكة.
وData at Rest أثناء وجودها داخل Backup Storage.
Immutable Backup: عندما لا تكفي صلاحية Administrator#
إذا حصل المهاجم على Administrator Credentials، فإن Backup تقليدية قد تصبح قابلة للحذف مثل أي Data أخرى.
وهنا تأتي:
Immutability
أي حماية Recovery Point من التعديل أو الحذف خلال فترة محددة وفق ضوابط النظام.
هذه الطبقة مصممة لتقليل أثر:
Ransomware، وسرقة الحسابات، والخطأ البشري، والحذف المتعمد.
الفكرة المهمة هي أن Recovery Copy يجب أن تبقى موثوقة حتى عندما تصبح Production Environment أو بعض الحسابات الإدارية نفسها غير موثوقة.
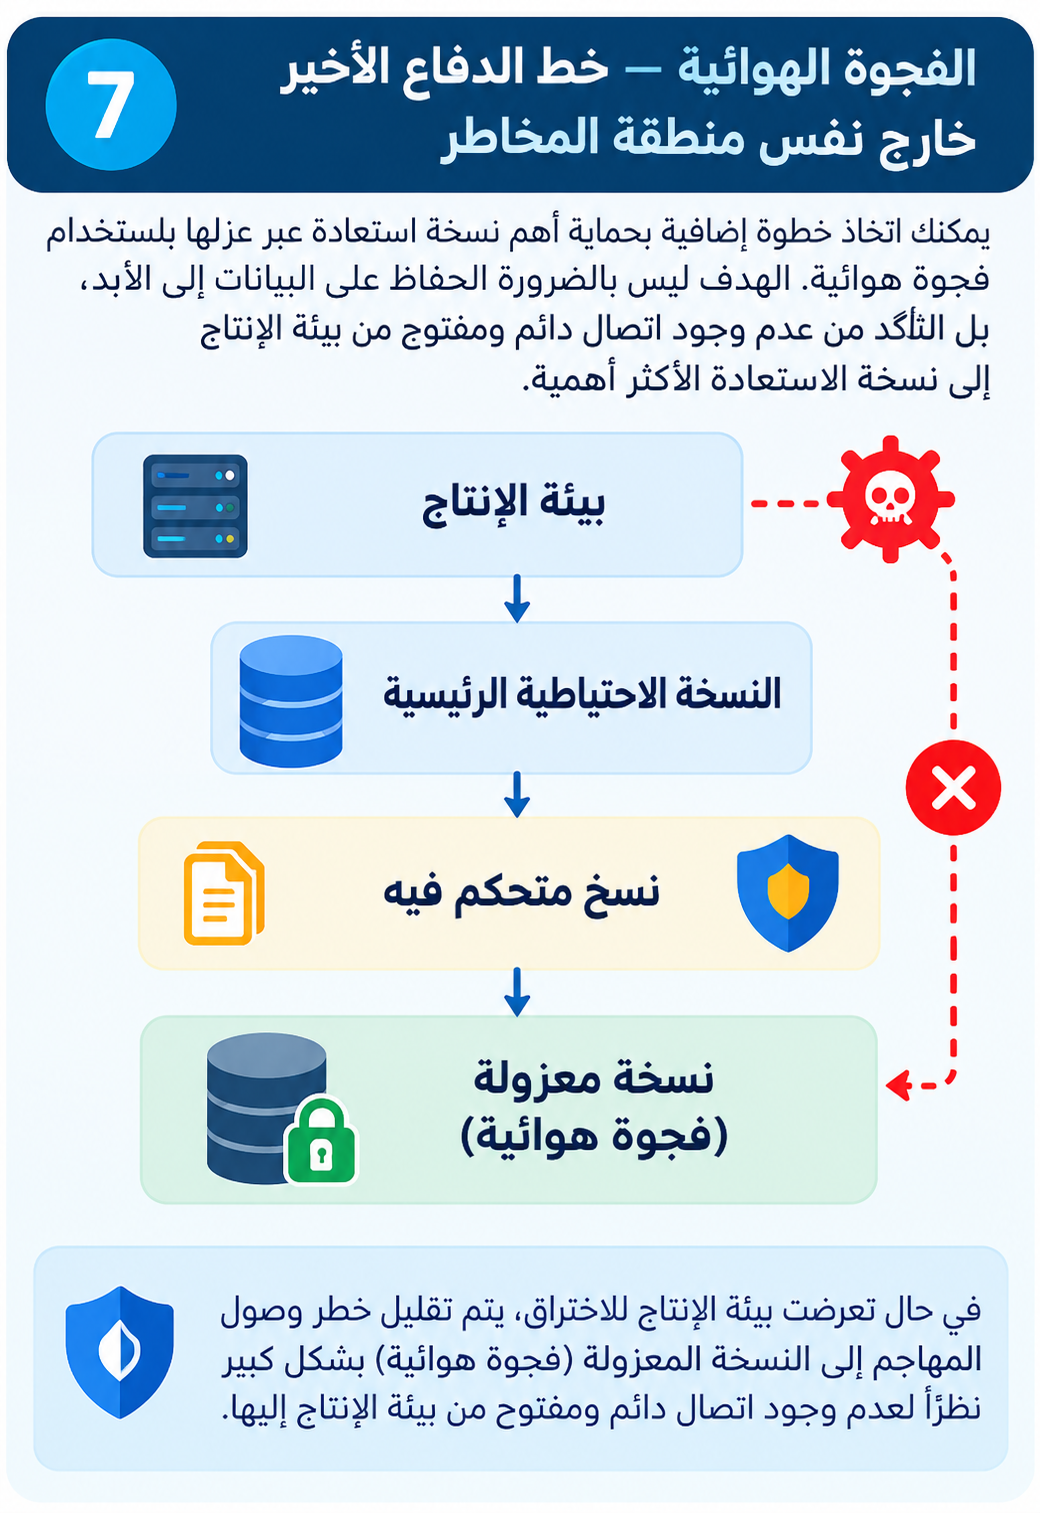
Air Gap: إخراج آخر خط دفاع من نفس دائرة الخطر#
يمكن الذهاب خطوة أبعد.
بدلاً من ترك النسخة الحرجة متاحة طوال الوقت عبر الشبكة نفسها، يمكن إضافة مستوى من العزل باستخدام Air Gap.
الهدف ليس بالضرورة أن تصبح البيانات بلا اتصال إلى الأبد، بل أن لا يوجد طريق مفتوح ودائم من Production إلى أهم Recovery Copy.
قد يصبح المسار:
Production → Primary Backup → Controlled Replication → Isolated Copy
إذا تعرضت Production للاختراق، يقل احتمال وصول الهجوم بالطريقة نفسها إلى النسخة المعزولة.
ليست كل Recovery Point متساوية#
من السهل افتراض أن أحدث Backup هي الأفضل.
لكن ماذا لو بدأ Corruption قبل أسبوع؟
أو تم حذف ملف منذ 20 يوماً ولم يلاحظ أحد؟
أو دخل مهاجم إلى البيئة قبل أن يبدأ التشفير بعدة أيام؟
عندها يمكن أن تكون أحدث Backup تحتوي على المشكلة نفسها.
لهذا نحتاج إلى Retention Policy.
قد تحتفظ المنصة بنقاط يومية للفترة القريبة، وأسبوعية لفترة أطول، وشهرية أو Long-Term Copies للاحتياجات التاريخية أو التنظيمية.
السؤال الحقيقي هنا ليس:
كم Backup نحتفظ؟
بل:
إلى أي مدى في الماضي نريد الاحتفاظ بإمكانية العودة؟
RPO وRTO: عندما تتحول Backup من قرار تقني إلى قرار أعمال
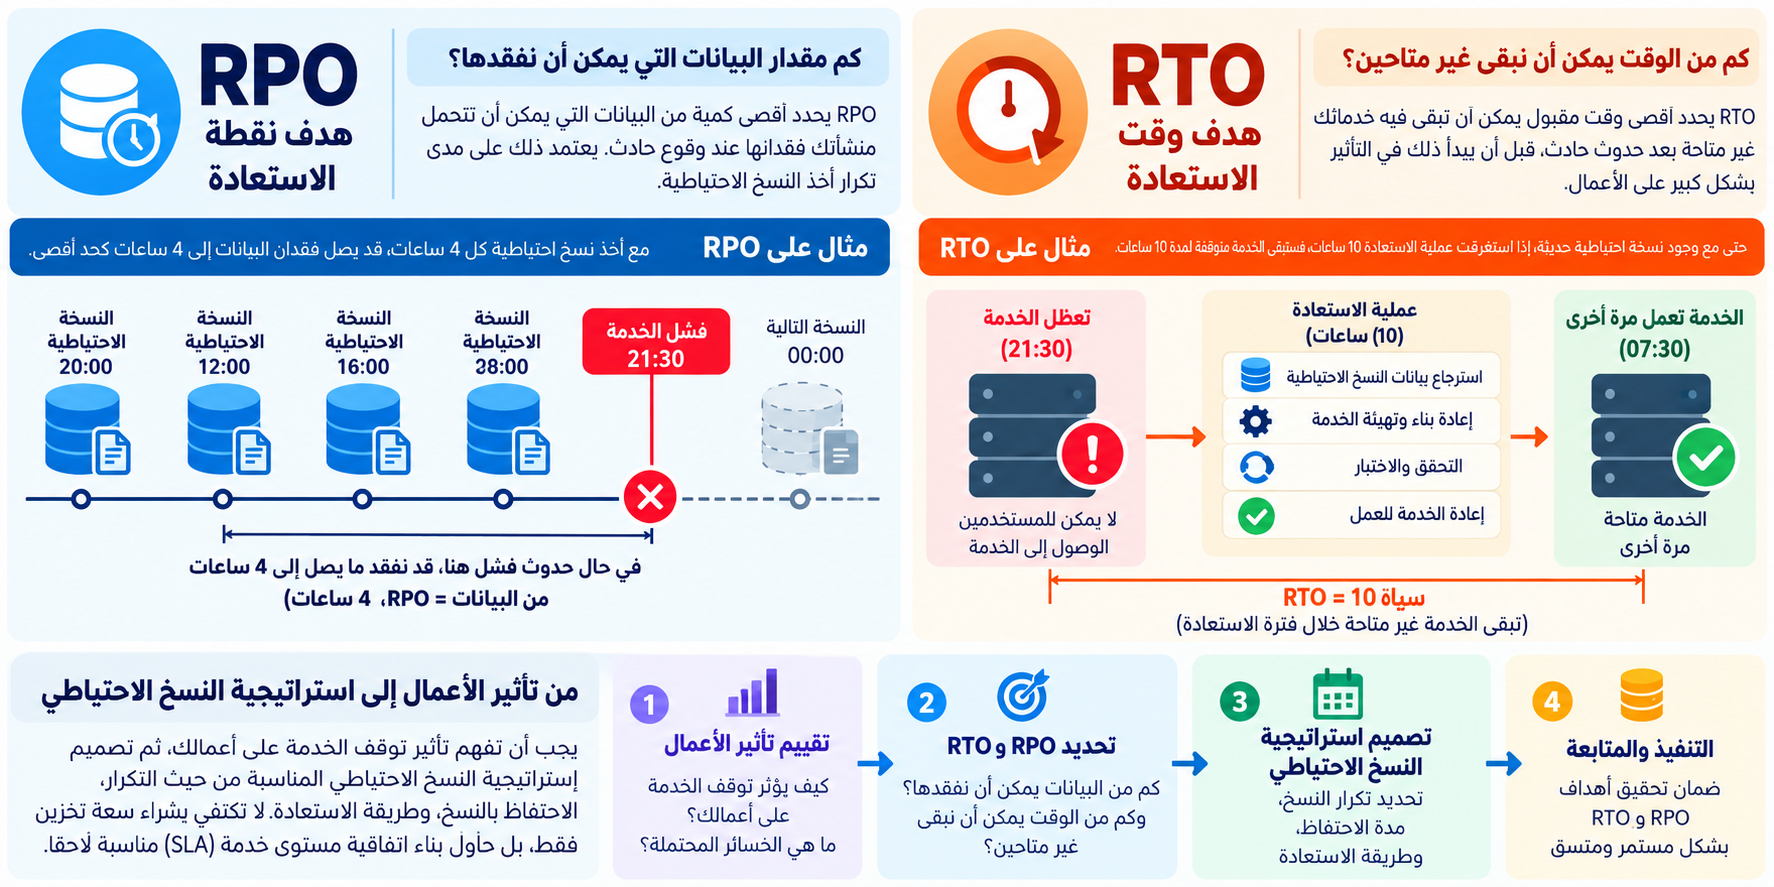
هناك رقمان يحددان قيمة استراتيجية Backup أكثر من حجم الـStorage نفسه.
RPO يقيس مقدار البيانات الذي يمكن خسارته، بينما RTO يقيس الزمن المقبول قبل عودة الخدمة.
Recovery Point Objective — RPO#
يجيب عن السؤال:
كم من البيانات يمكن أن نخسر؟
إذا كانت Backup كل أربع ساعات، فقد يكون مقدار الخسارة المحتمل قريباً من أربع ساعات من البيانات.
بالنسبة إلى File Server عادي قد يكون ذلك مقبولاً.
أما بالنسبة إلى نظام معاملات مالية فقد لا يكون كذلك.
Recovery Time Objective — RTO#
يجيب عن السؤال الآخر:
كم تستطيع الخدمة أن تبقى متوقفة؟
قد تمتلك Recovery Point عمرها عشر دقائق فقط، لكن إذا احتاج Restore إلى عشر ساعات فإن RTO لا يزال سيئاً.
إذن:
RPO = How much data can we lose?
RTO = How long can we remain unavailable?
لهذا يجب أن تبدأ المؤسسة بتأثير توقف الخدمة على العمل، ثم تصمم Backup Frequency وRetention وRecovery Method، لا أن تبدأ بشراء Storage ثم تحاول بناء SLA حولها لاحقاً.
الرحلة الثانية: من Recovery Point إلى خدمة تعمل من جديد#
حتى هذه اللحظة، كنا نسير في اتجاه واحد:
Production → Backup
لكن القيمة الحقيقية تظهر عندما نعكس الرحلة.
ففي الحادث الحقيقي، يجب أن تتحول Recovery Point من مجموعة بيانات مخزنة إلى:
File قابل للاستخدام، أو Database تعمل ،أو VM تقلع، أو خدمة كاملة يعود إليها المستخدمون.
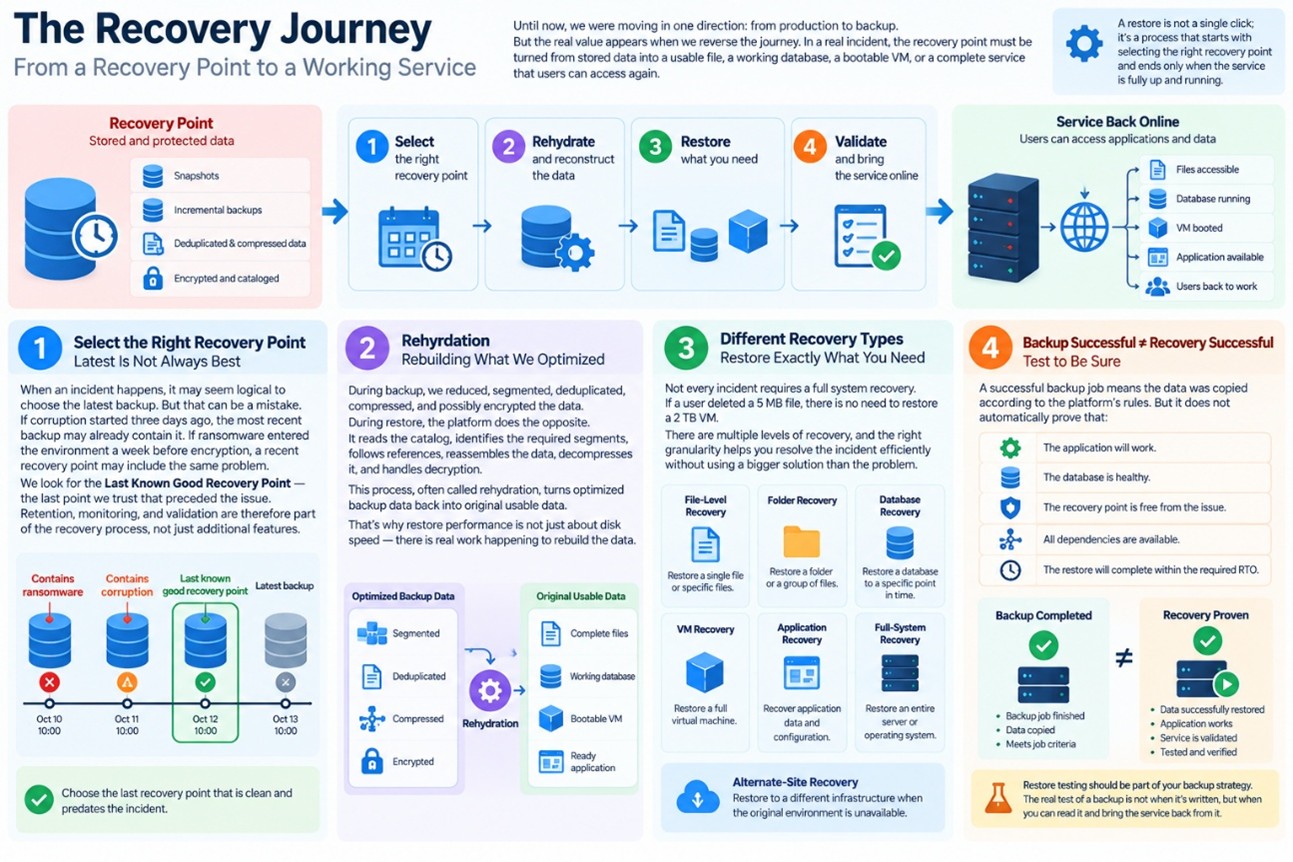
Restore ليست نقرة واحدة؛ هي عملية تبدأ باختيار النسخة الصحيحة وتنتهي فقط بعد التأكد من عودة الخدمة نفسها.
اختيار النسخة الصحيحة: Latest ليست دائماً Best#
عند حدوث Incident، قد يبدو منطقياً اختيار أحدث Backup مباشرة.
لكن هذا قد يكون خطأ. إذا بدأ Corruption قبل ثلاثة أيام، فإن آخر نسخة قد تحتوي عليه.
وإذا دخل Ransomware البيئة قبل أسبوع من بدء التشفير، فقد تعيد نسخة حديثة المشكلة نفسها.
لذلك نبحث عن:
Last Known Good Recovery Point
أي آخر نقطة نثق بأنها سبقت المشكلة.
وهنا تصبح Retention وMonitoring والتحقق من النسخة جزءاً من Recovery، وليس مجرد Features إضافية.
Rehydration: إعادة بناء ما قمنا بتحسينه#
أثناء Backup قمنا بتقليل البيانات وتجزئتها وإزالة التكرار منها وضغطها وربما تشفيرها.
أثناء Restore يجب عكس ذلك. تقرأ المنصة الـCatalog، وتحدد الـSegments المطلوبة، وتتبع References، وتعيد ترتيب البيانات، وتفك Compression، وتعالج Encryption.
وبذلك تتحول:
Optimized Backup Data
مرة أخرى إلى:
Original Usable Data
وتسمى هذه العملية في بعض البيئات Rehydration.
ولهذا لا تعتمد سرعة Restore فقط على Disk Speed؛ توجد عملية حقيقية لإعادة بناء البيانات.
Recovery لا تعني دائماً استعادة النظام بالكامل#
إذا حذف مستخدم File حجمه 5 MB، فلا معنى لاستعادة VM كاملة بحجم 2 TB.
ولهذا توجد مستويات متعددة من Recovery.
قد تحتاج:
File-Level Recovery ، أو Folder Recovery ، أو VM Recovery ،أو Database Recovery ،أو Application Recovery ، او Full-System Recovery
وقد تحتاج إلى Alternate-Site Recovery إذا لم تعد البيئة الأصلية متاحة.
كلما كانت Recovery Granularity أفضل، استطعت معالجة الحادث بالطريقة المناسبة بدلاً من استخدام حل أكبر من المشكلة نفسها
Backup Successful لا تعني Recovery Successful#
هذه واحدة من أخطر الافتراضات في عالم Backup.
إذا ظهرت Job بنجاح، فهذا يعني أن عملية النسخ اكتملت وفق الشروط التي تتحقق منها المنصة.
لكن ذلك لا يثبت تلقائياً أن: الـApplication ستعمل.
Database سليمة.
Recovery Point خالية من المشكلة.
جميع Dependencies متوفرة.
أو أن Restore ستتم ضمن RTO المطلوب.
هناك فرق كبير بين:
Backup Completed
و:
Recovery Proven
ولهذا يجب أن تكون Restore Testing جزءاً من استراتيجية الحماية.
فالاختبار الحقيقي للنسخة الاحتياطية لا يحدث عندما تتم كتابتها.
بل عندما تستطيع قراءتها وإعادة الخدمة منها.
أين تأتي Backup as a Service في كل هذه الرحلة؟#
يمكن للمؤسسة أن تبني كل ما سبق داخلياً.
Backup Servers، Repositories، Networking ، Licensing، Monitoring، Security، Retention، Capacity Planning، Offsite Copies، Restore Testing.
لكن بناء المنصة يعني أيضاً تحمل مسؤولية تشغيلها وصيانتها وتوسعتها وتأمينها باستمرار.
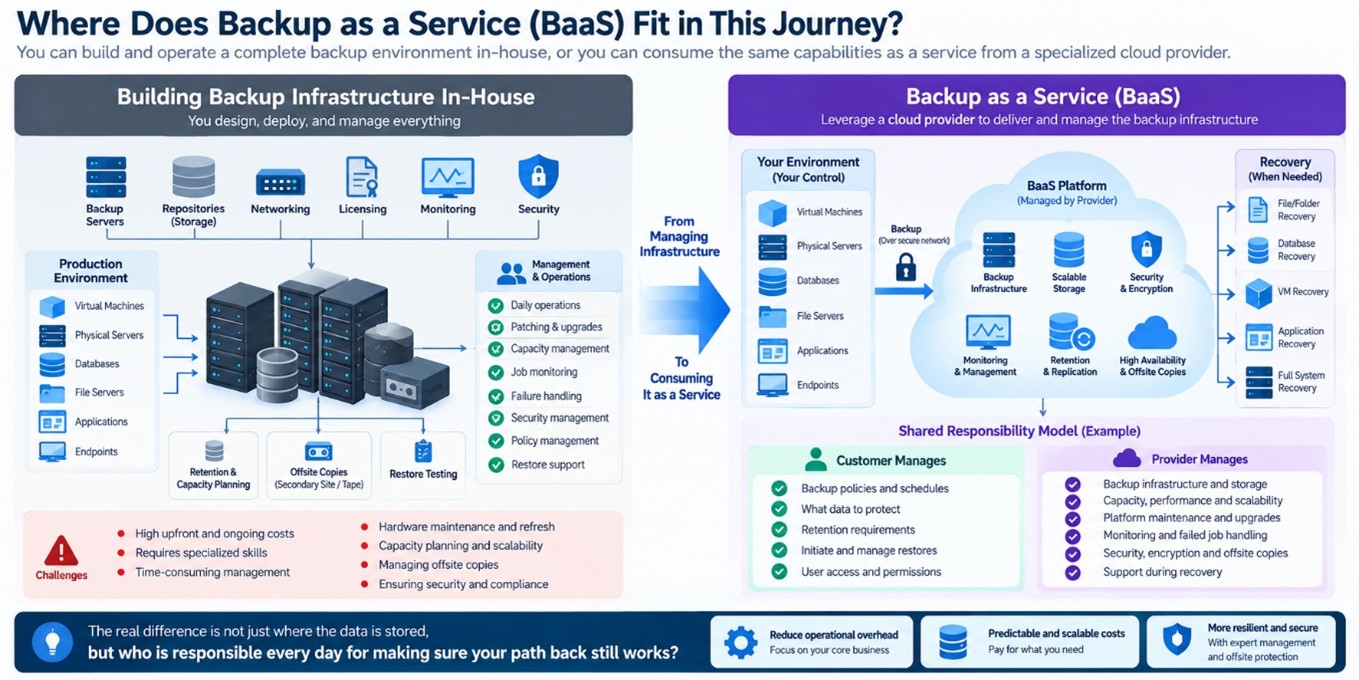
وهنا تظهر الفكرة الحقيقية لـ Backup as a Service.
باعتبارنا مزودي خدمات سحابية، لا ننظر إلى BaaS على أنها مجرد مساحة نرسل إليها البيانات.
الفكرة الأوسع هي تحويل جزء كبير من Backup Infrastructure Lifecycle إلى Service.
في نموذج يمكن أن يدير فيه العميل Policies وRestore بينما يدير المزود Infrastructure، أو يمكن أن يصبح النموذج أكثر إدارة بحيث يشمل Monitoring وPlatform Maintenance ومعالجة Jobs والمساعدة أثناء Recovery.
الفرق الحقيقي ليس فقط:
أين توجد البيانات؟
بل:
من المسؤول كل يوم عن التأكد من أن مسار العودة ما زال يعمل؟
الخلاصة: Backup ليست نهاية الرحلة… بل بداية العودة#
في الأيام العادية، تعمل النسخ الاحتياطية بصمت، تنسخ البيانات، تستهلك Storage،.وترسل تقارير.
لكن في اليوم الذي تتوقف فيه خدمة حرجة، تصبح فجأة واحدة من أهم الأنظمة في المؤسسة.
وفي ذلك اليوم لن يكون السؤال:
كم Job نجحت هذا الشهر؟
بل:
ما آخر Recovery Point سليمة؟
كم من البيانات سنخسر؟
كم ستستغرق العودة؟
وهنا تظهر القيمة الحقيقية لـ Backup as a Service.
فهي ليست مجرد عملية لنقل البيانات من Server إلى backup system.
إنها رحلة تحول البيانات الحيّة والمتغيرة داخل Production إلى Recovery Points موثوقة ومحميّة، تستطيع عند الحاجة إعادتها.
تقييم المقال
كن أول من يقيّم هذا المقال
التعليقات والمناقشات0
مقالات ذات صلة
دليل مهندس البنية التحتية لخدمات الـ Co-Location: بين المتطلبات الهندسية وجدوى الانتقال  الحوسبة السحابية
دليل مهندس البنية التحتية لخدمات الـ Co-Location: بين المتطلبات الهندسية وجدوى الانتقال
نظرة هندسية واقعية حول استضافة عتاد الخوادم والشبكات في مراكز بيانات الـ Co-Location، تغطي معايير الطاقة والتبريد، الربط الشبكي وخطوط الـ Uplinks، بالإضافة إلى أفضل الممارسات الميدانية لإدارة الكبائن وضمان استمرارية الخدمة.
Emad Al-Hadheri