أساسيات التعافي من الكوارث: تصميم استراتيجية DRaaS حديثة
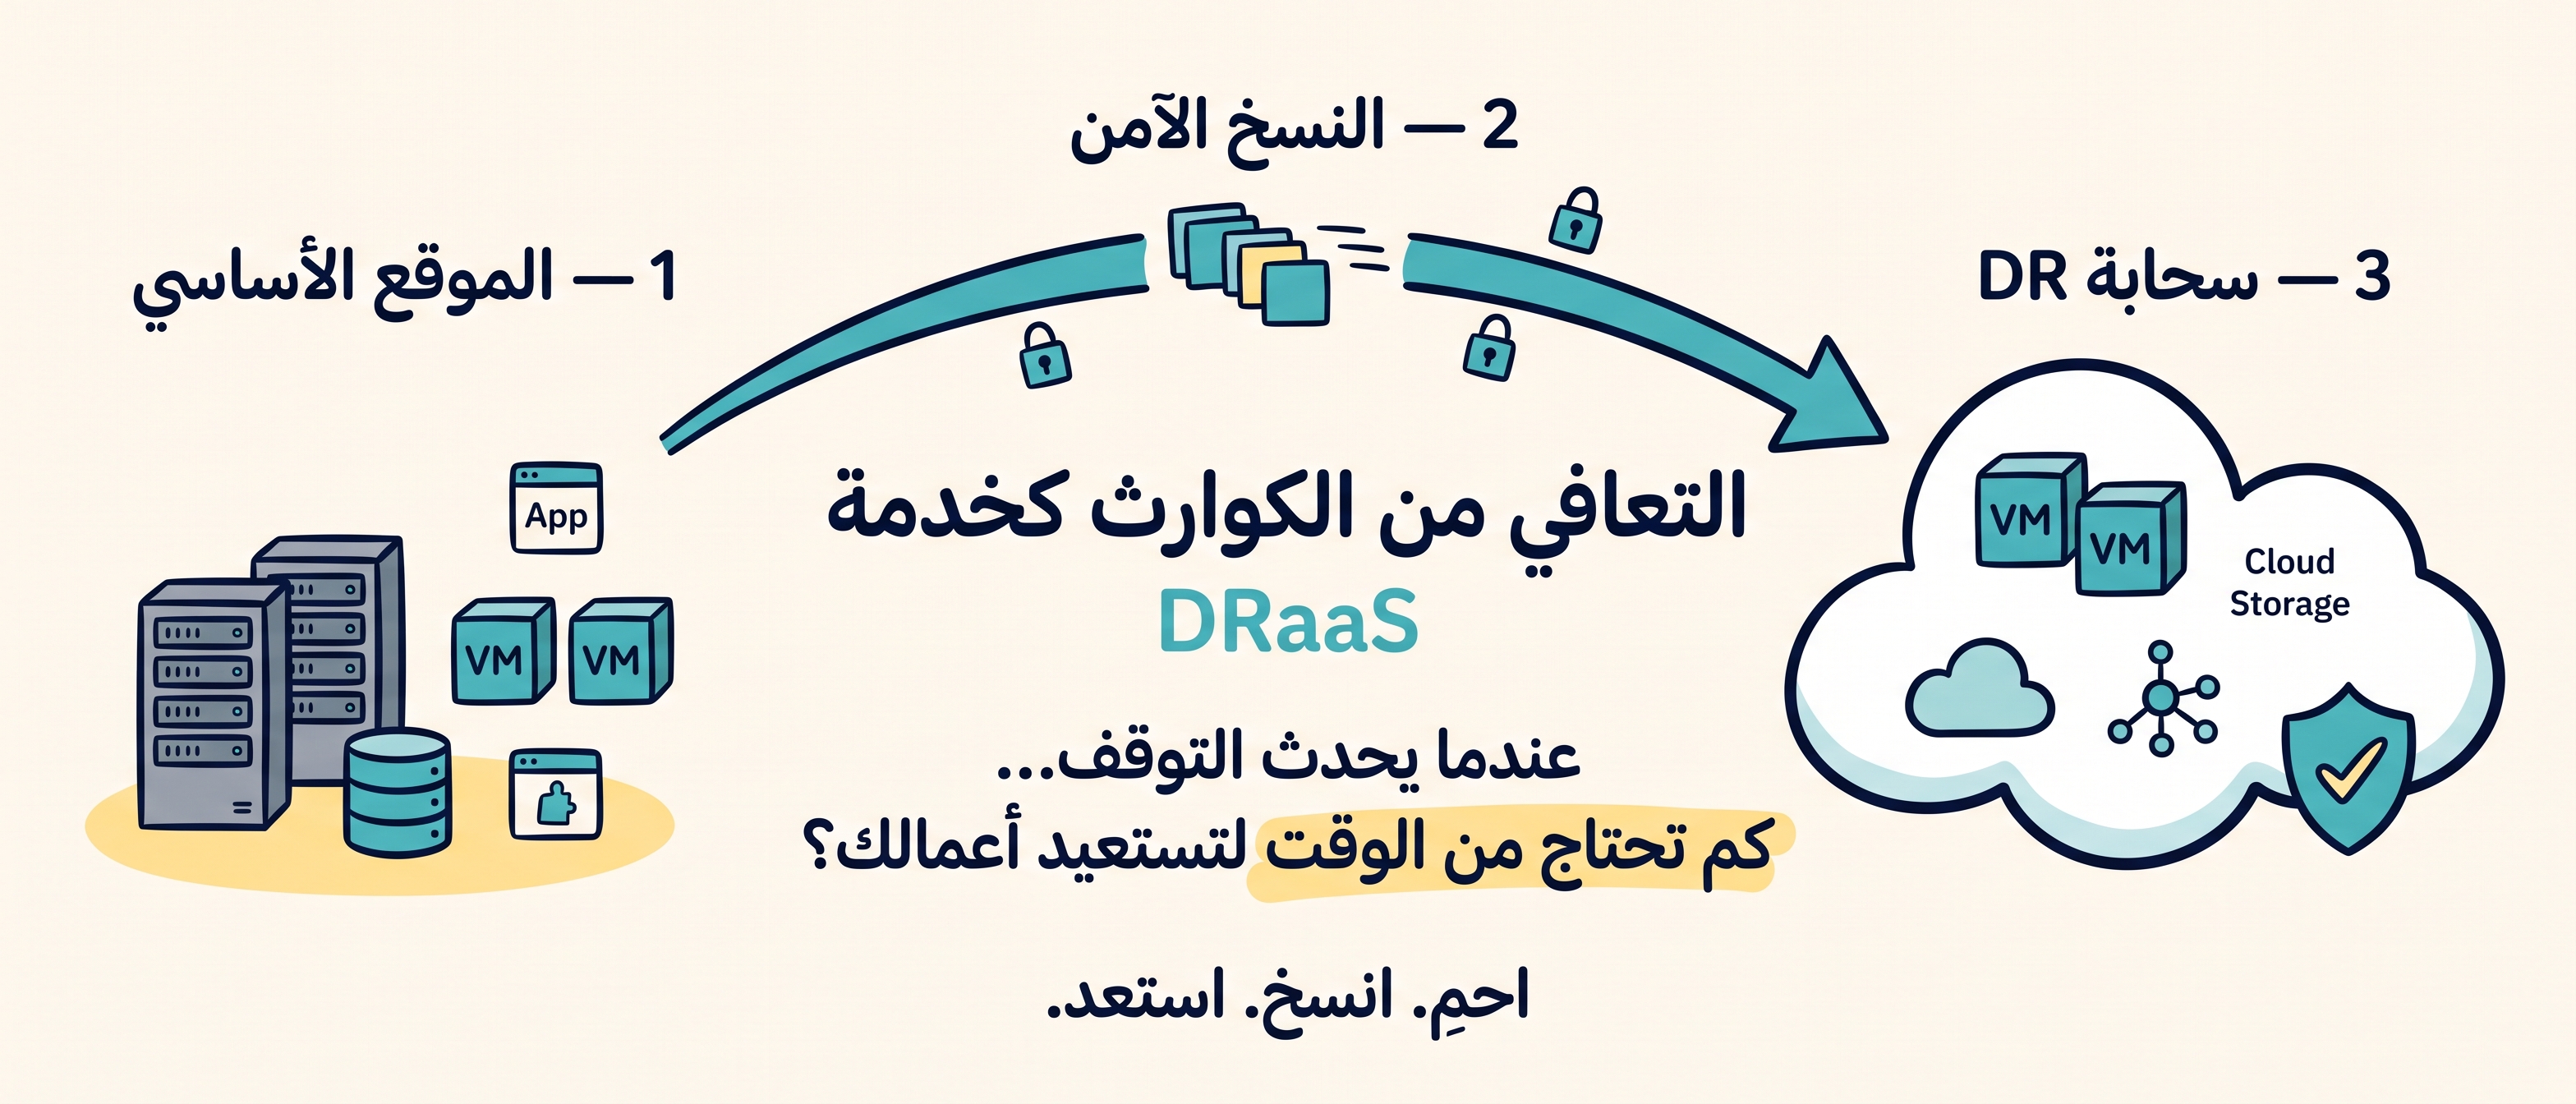
التعافي من الكوارث لا يعني فقط نسخ الأجهزة الافتراضية إلى موقع آخر.
بل يعني أن تعرف ما الذي يجب استعادته أولًا، وكم من البيانات يمكن للأعمال تحمل فقدانه، وكم يجب أن يستغرق استرجاع الخدمة، وما الخطوات التي يجب تنفيذها عندما تصبح البيئة الأساسية غير متاحة.
توفر البنية السحابية قدرات الحوسبة والتخزين والشبكات في موقع التعافي، لكن نجاح Disaster Recovery as a Service (DRaaS) يعتمد على أكثر من مجرد البنية التحتية. فالهندسة، وأهداف الاستعادة، وتصميم النسخ المتماثل، والأتمتة، والاختبارات، وإجراءات التشغيل كلها تحدد مدى نجاح التعافي عند وقوع حادث فعلي.
إليك منهجًا عمليًا لبناء استراتيجية DRaaS أكثر قوة ونضجًا.
1. ابدأ بتأثير الأعمال، وليس بالتقنية#
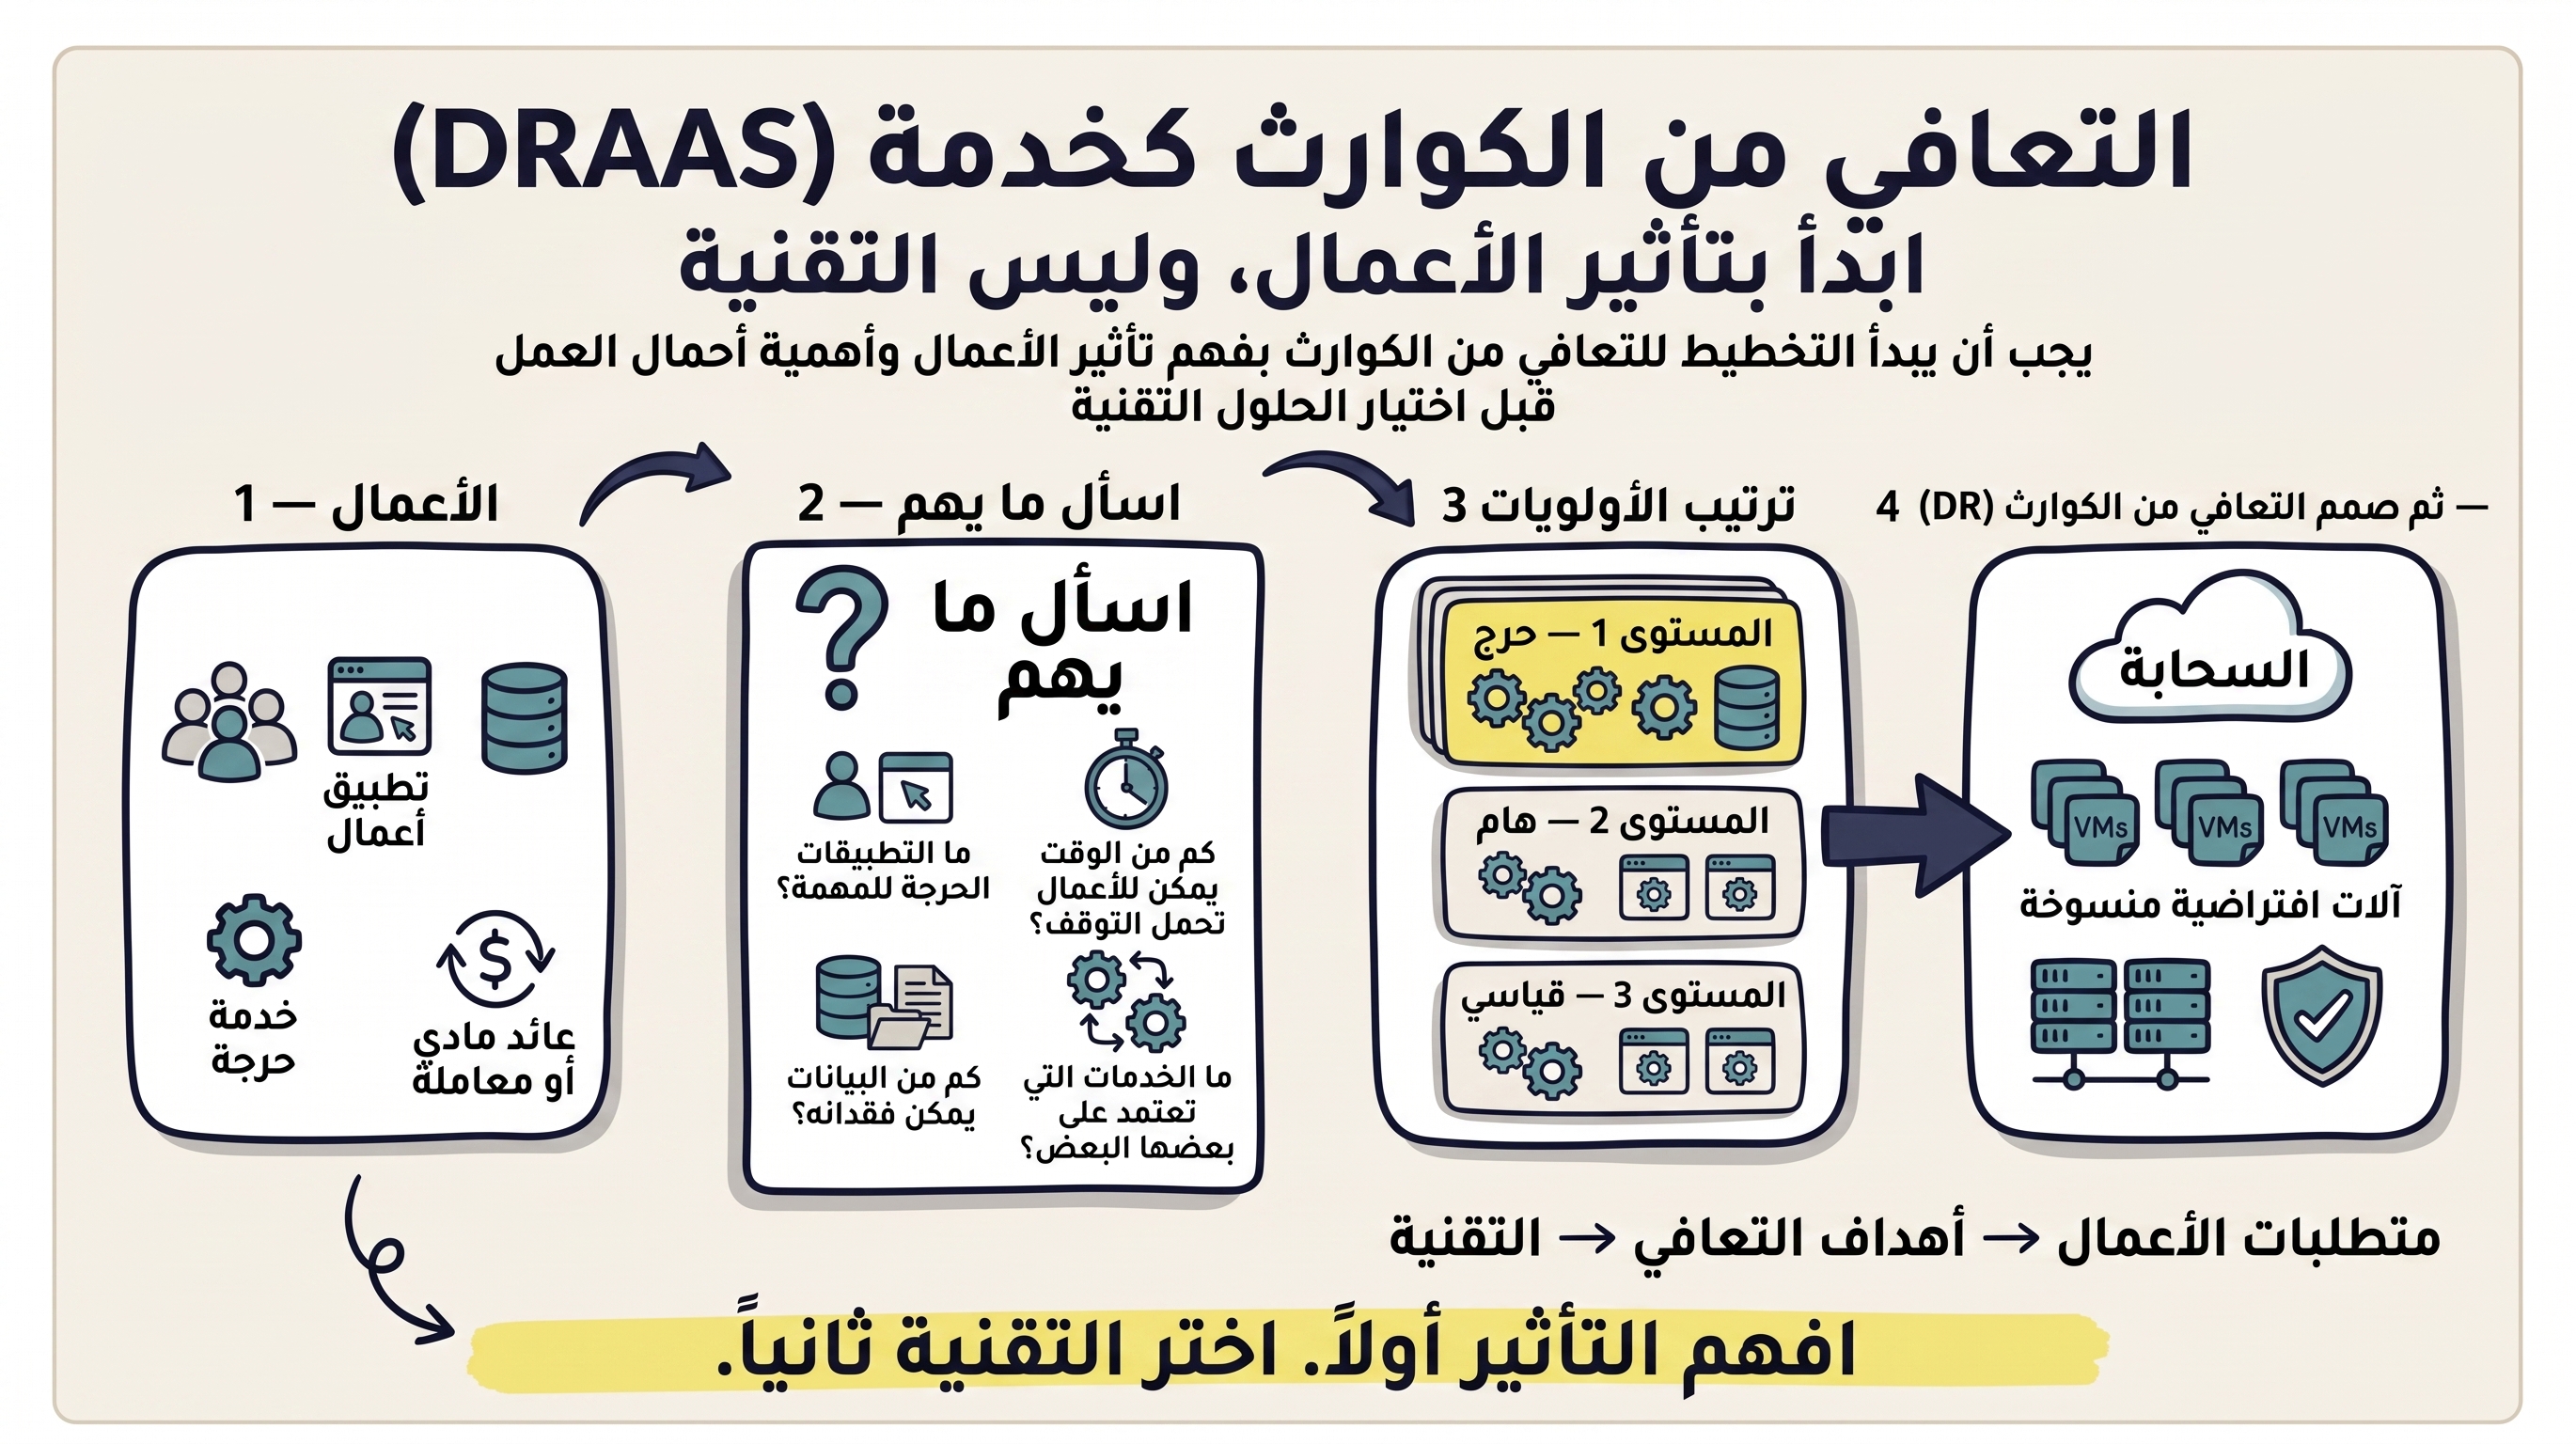
قبل اختيار منصة النسخ المتماثل أو السحابة أو موقع التعافي، حدد أولًا ما الذي يحتاج العمل فعلًا إلى حمايته.
ما التطبيقات ذات الأهمية الحرجة فعلًا؟
ماذا سيحدث إذا توقفت لمدة 15 دقيقة، أو ساعتين، أو يوم كامل؟
ما الأنظمة التي تعتمد على قواعد البيانات أو الهوية أو DNS أو الخدمات الخارجية؟
ما الفرق التي يجب أن تشارك أثناء عملية التعافي؟
كلما فهمت تأثير التوقف على الأعمال بصورة أفضل، استطعت تصميم بنية تعافٍ أكثر دقة وواقعية.
2. حدّد RPO وRTO قبل اختيار المنصة#
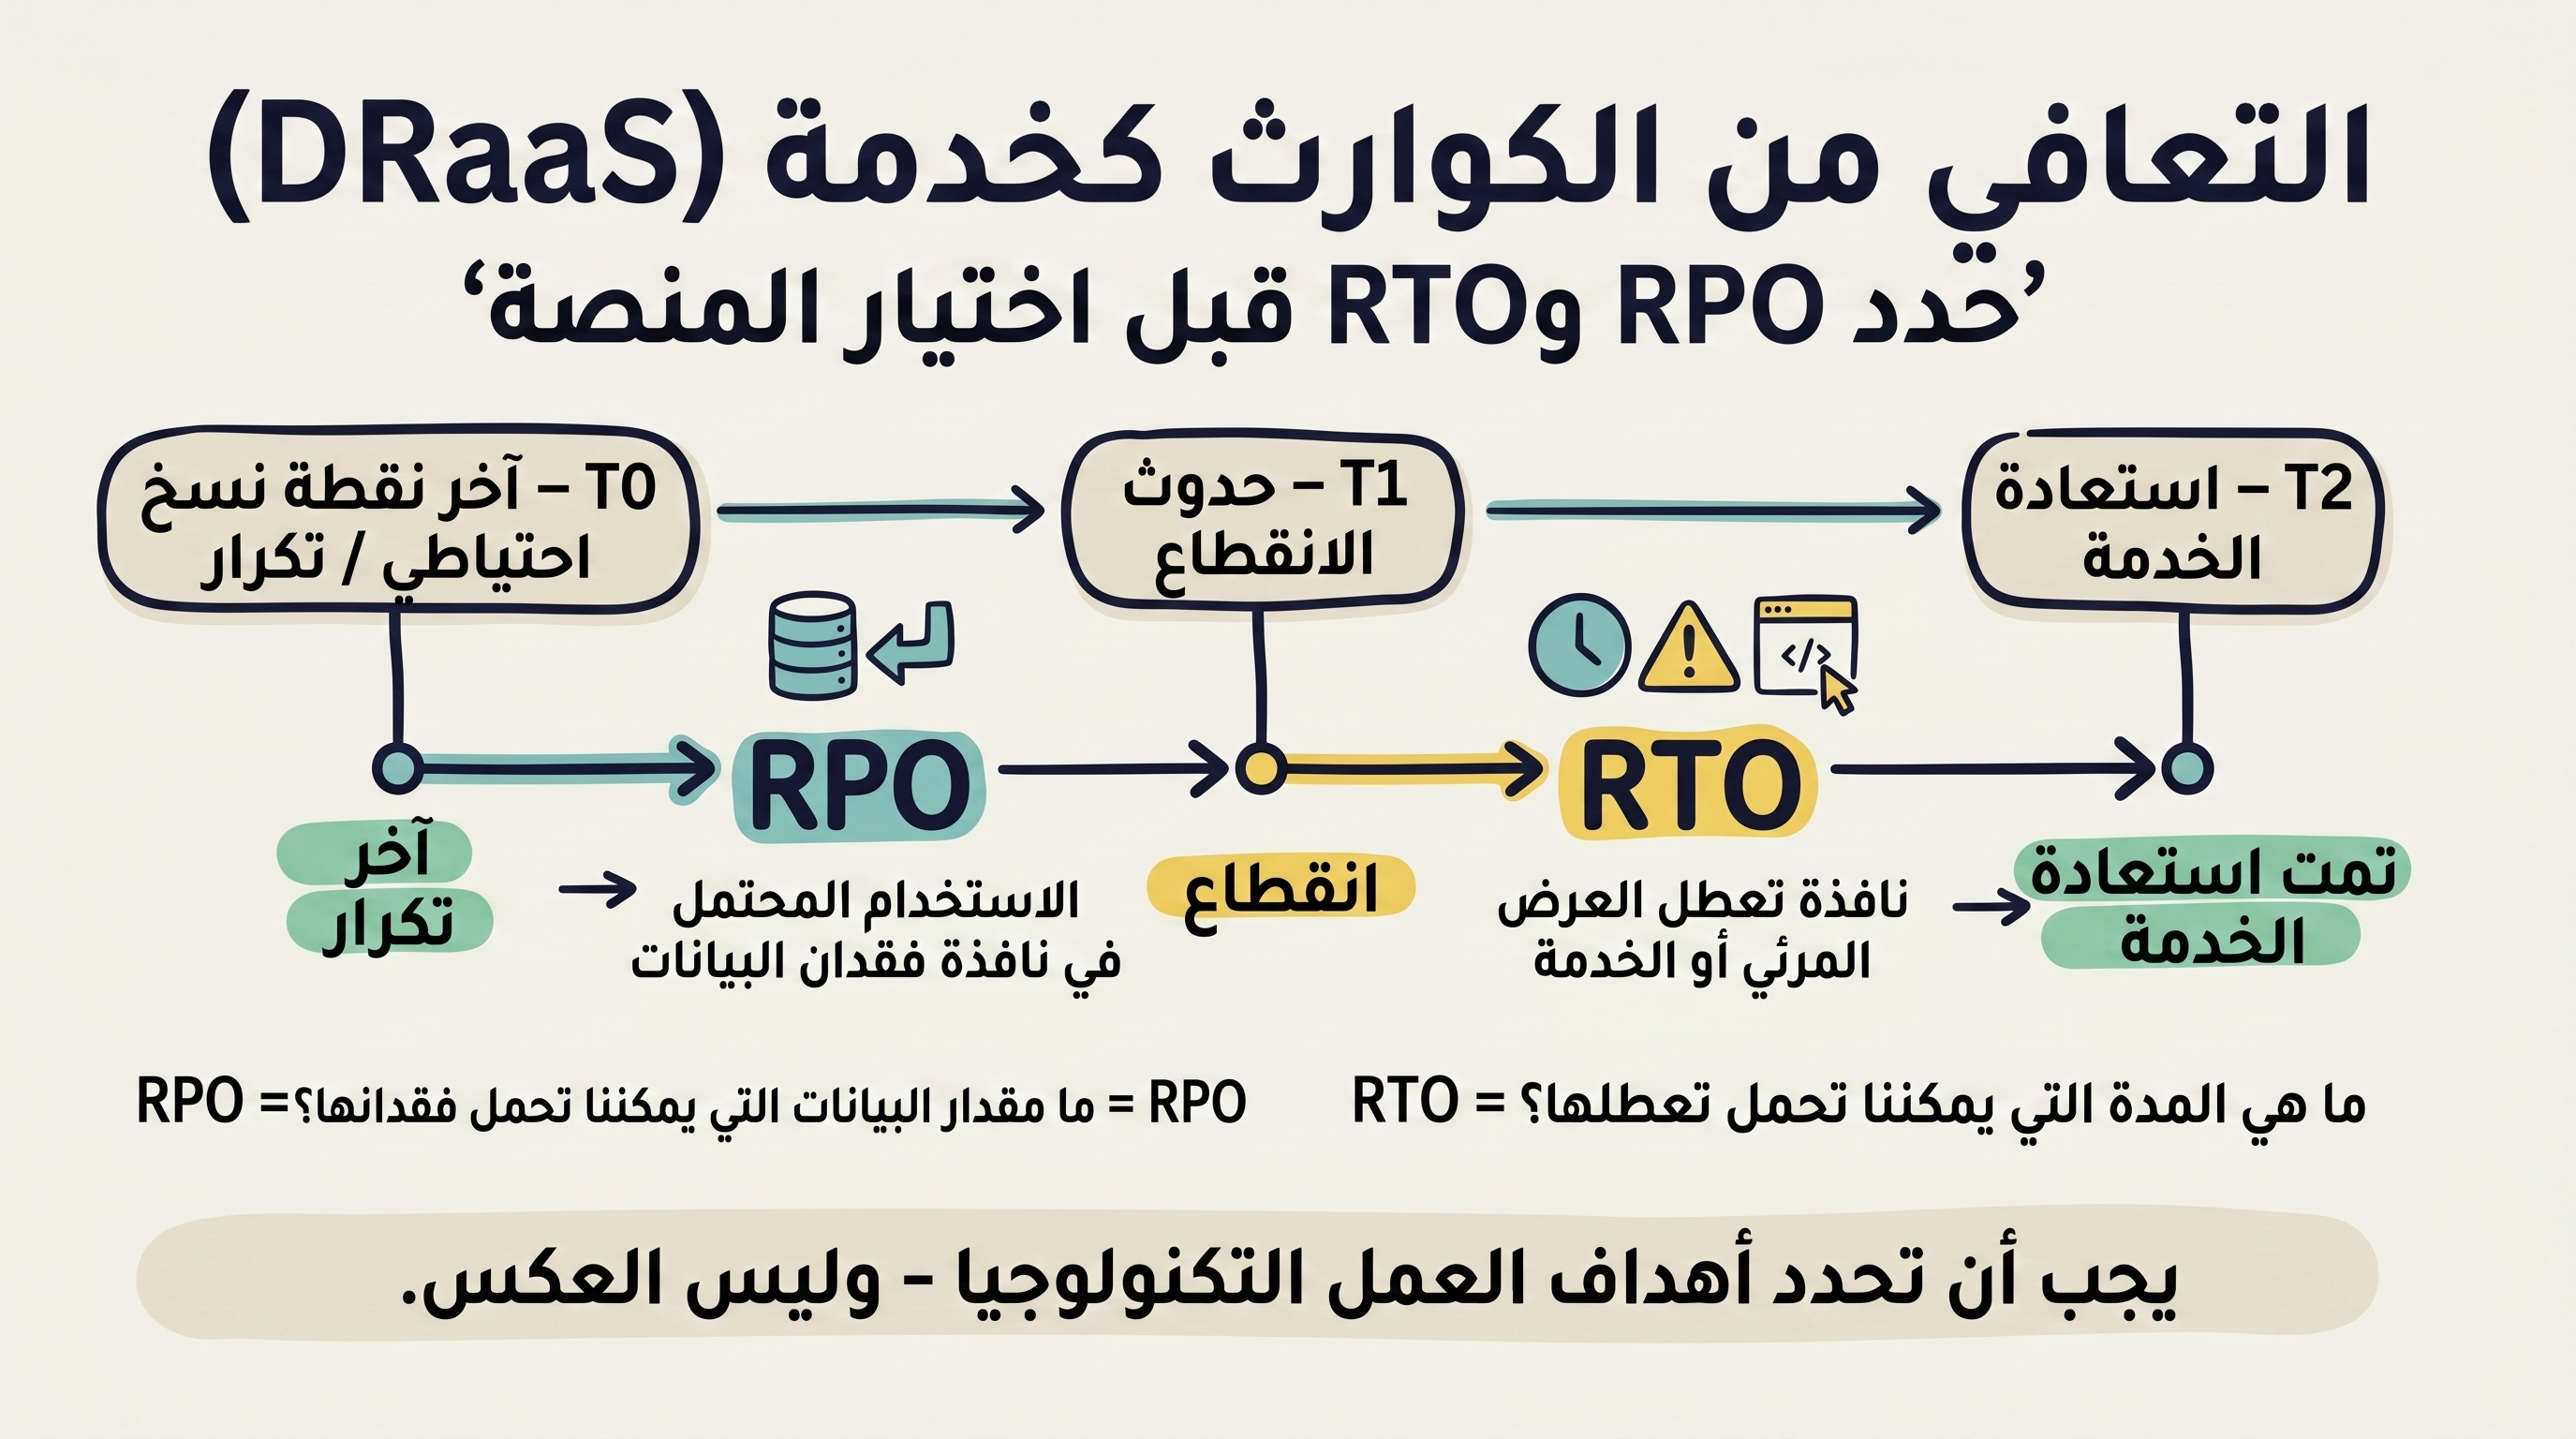
يُعد RPO وRTO من أهم المؤشرات التي تحدد تقريبًا جميع قرارات التعافي من الكوارث.
هدف نقطة الاستعادة (RPO): مقدار فقدان البيانات الذي يمكن للمنشأة تحمله.
هدف زمن الاستعادة (RTO): المدة القصوى المقبولة لبقاء الخدمة غير متاحة.
يجب ألا تحصل جميع الأحمال على نفس أهداف التعافي.
ينبغي أن تقود هذه الأهداف تكرار النسخ، وعرض النطاق، والأتمتة، والتكلفة.
RPO وRTO متطلبات أعمال أولًا، ثم تتحول بعد ذلك إلى إعدادات تقنية.
3. صمّم للتعامل مع ما هو أكثر من فشل الأجهزة#
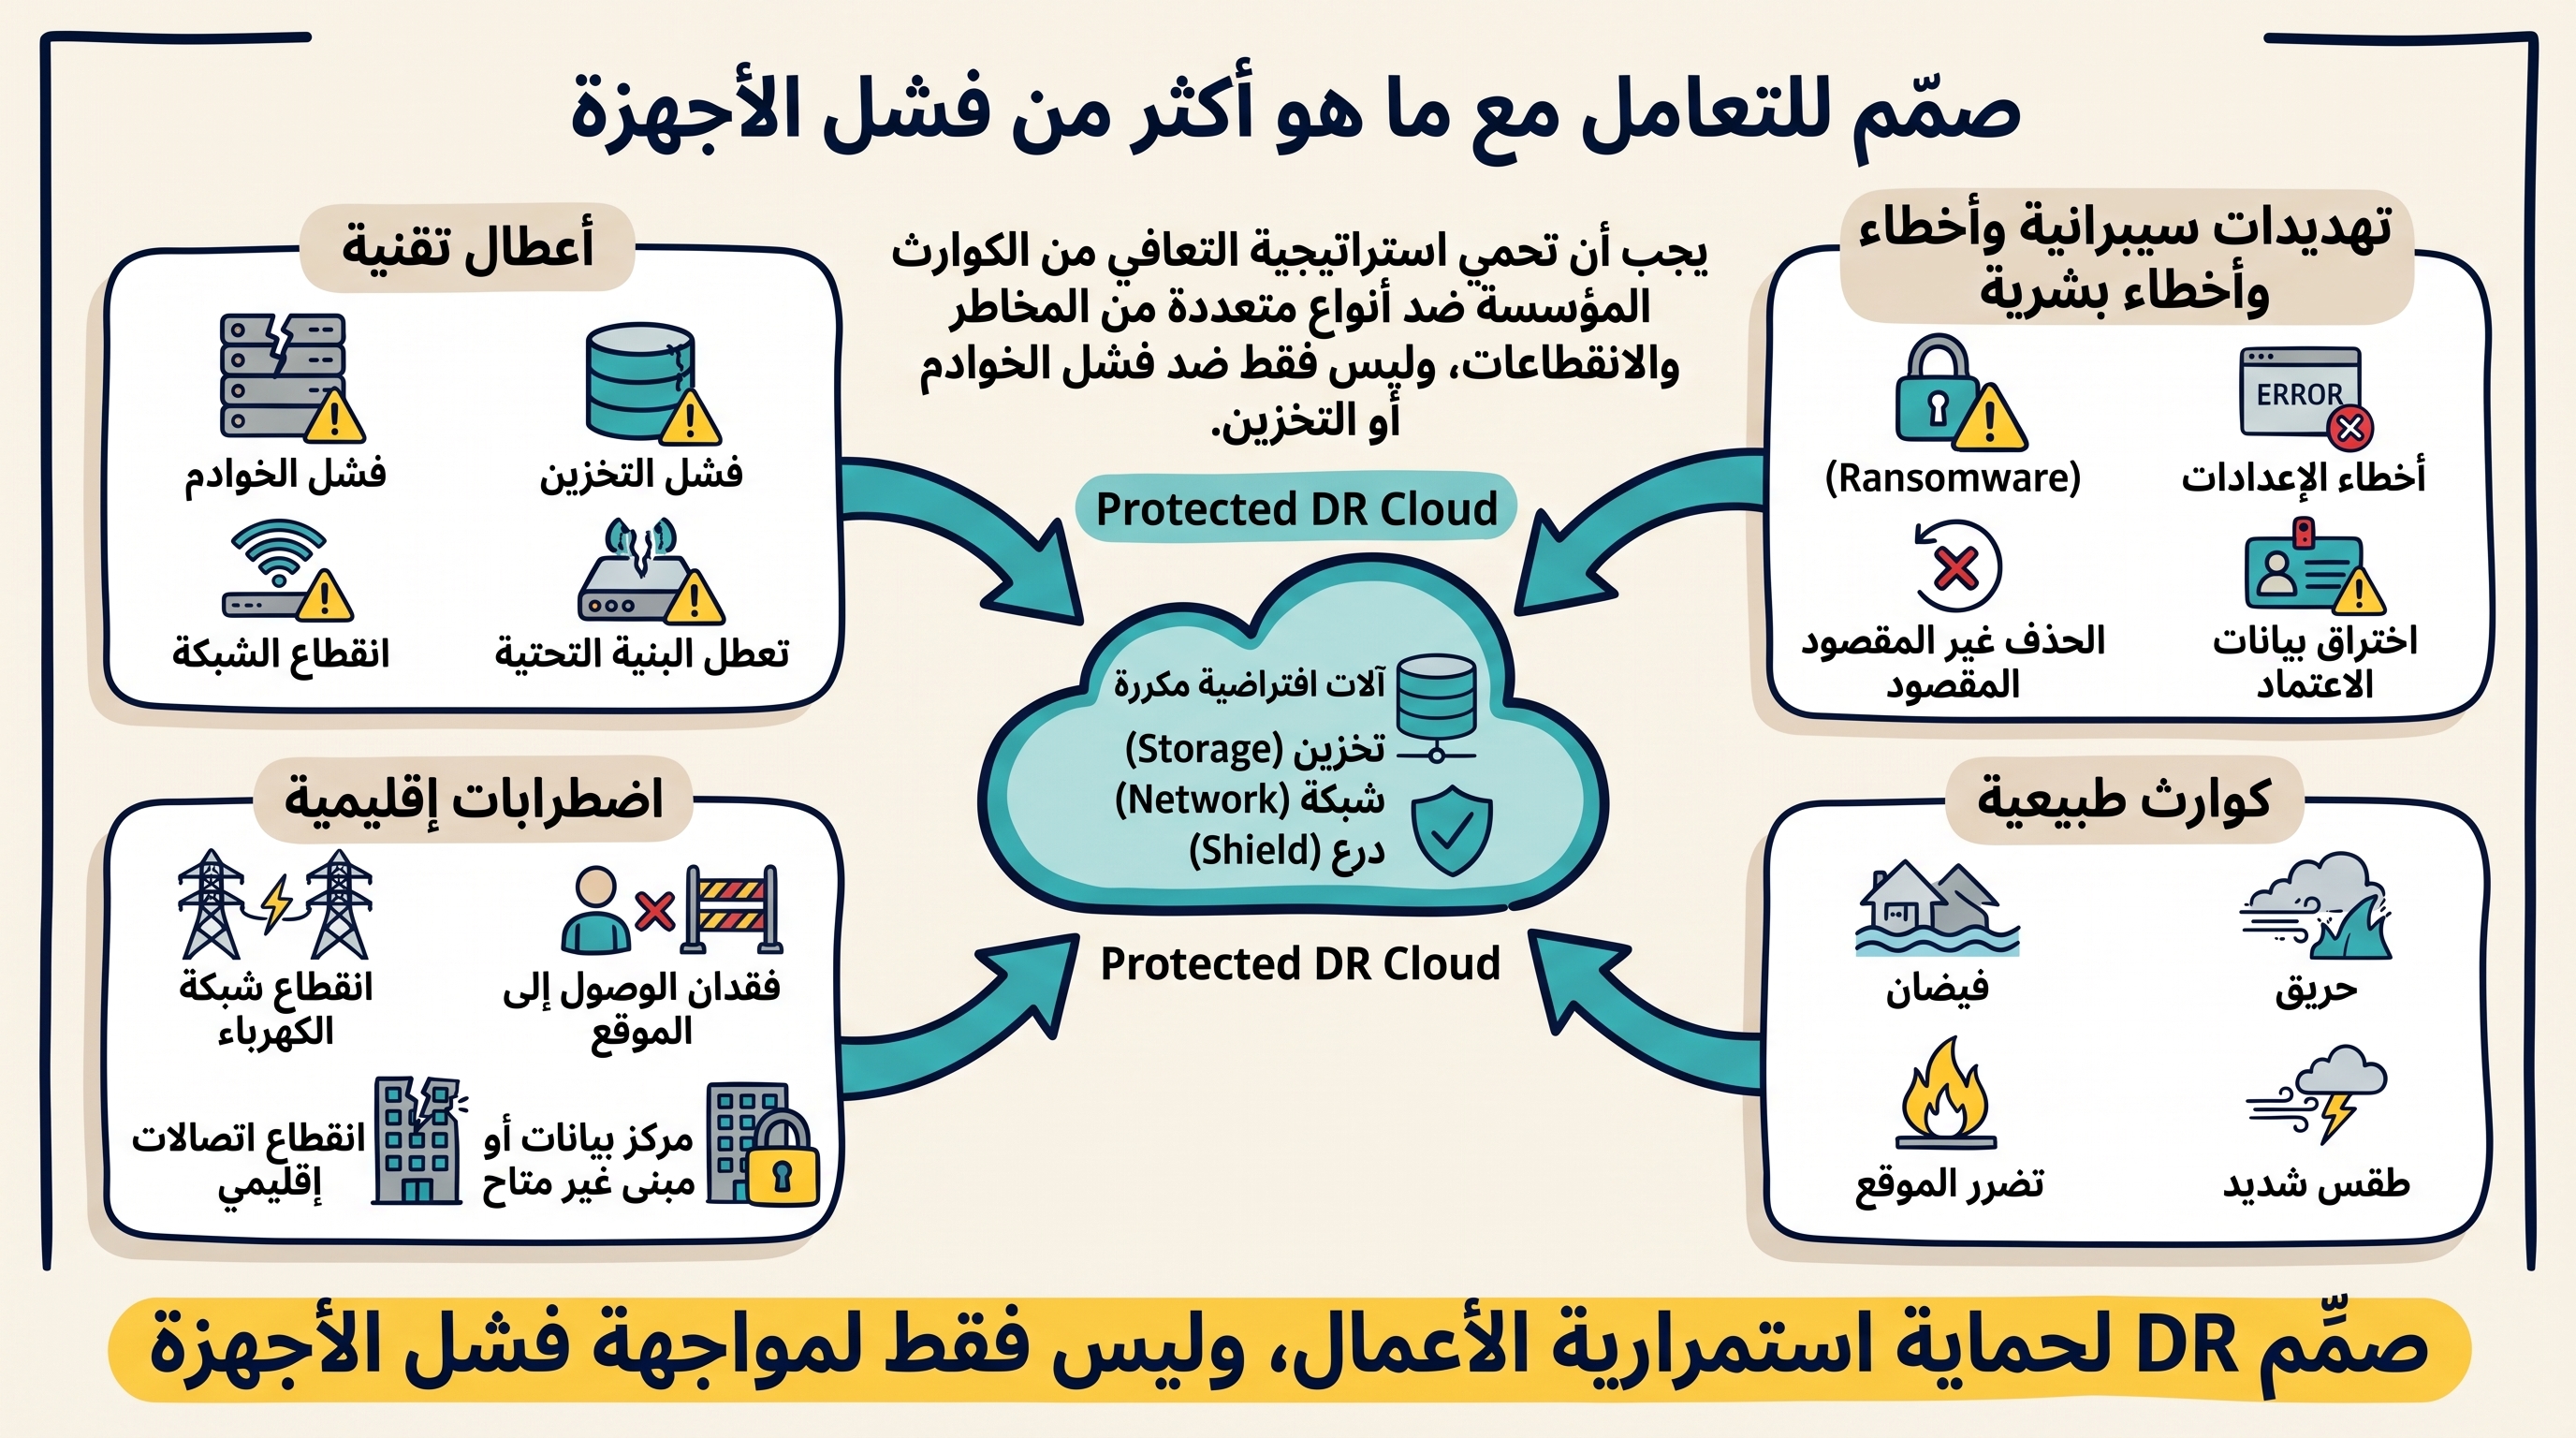
فترض البنية المرنة أن الانقطاع قد ينتج عن التقنية أو الأشخاص أو الهجمات السيبرانية أو البيئة المادية.
فشل المضيفين أو التخزين أو الشبكة أو الطاقة
الأخطاء البشرية والحذف غير المقصود
برامج الفدية وسرقة بيانات الاعتماد
الكوارث الطبيعية وتعطل المنشآت
الأزمات الإقليمية أو فقدان الوصول إلى الموقع
استراتيجية DR قوية تحمي من فقدان البنية التحتية ومن فساد البيانات المنطقي في الوقت نفسه.
4. استخدم النسخ الاحتياطي وDRaaS معًا#
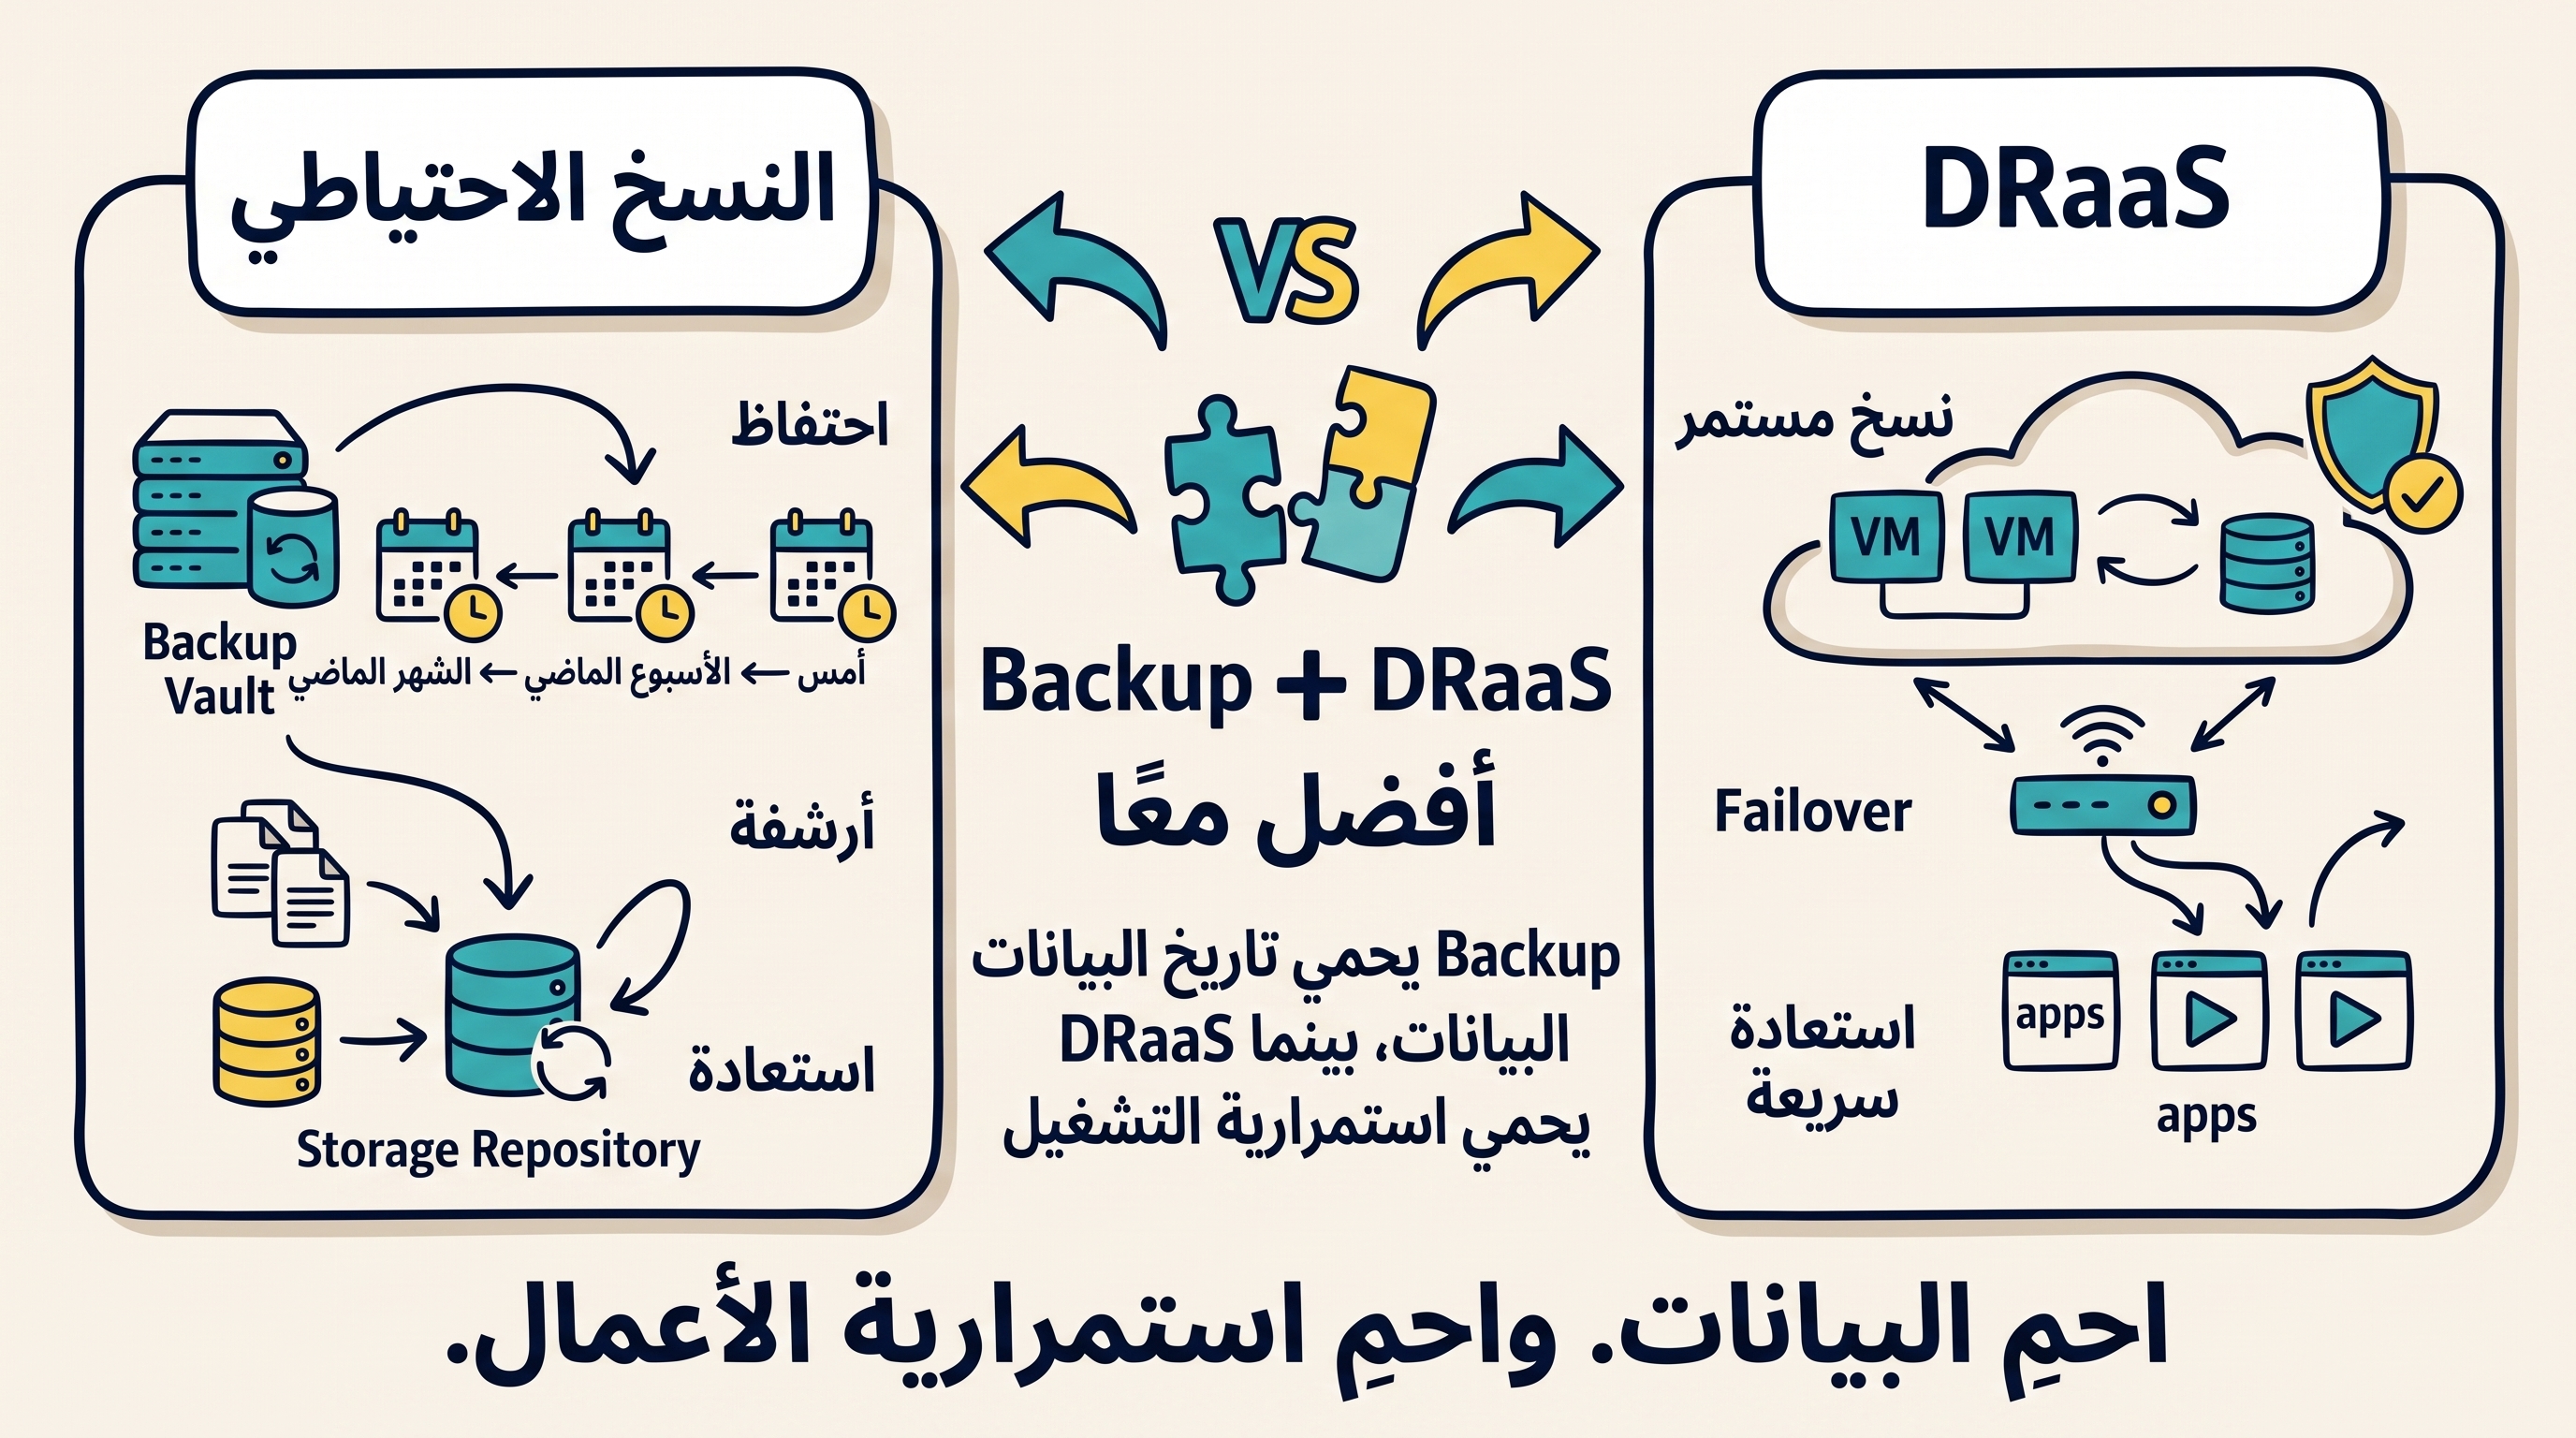
النسخ الاحتياطي وDRaaS يعالجان مشكلتين مختلفتين، والاستراتيجية الناضجة عادةً تحتاج إليهما معًا.
الهدف الأساسي#
BaaS: الاحتفاظ بالبيانات ونسخ قابلة للاستعادة
DRaaS: استمرارية التطبيقات والخدمات
طريقة الاستعادة المعتادة#
BaaS: استعادة البيانات أو الأنظمة
DRaaS: تشغيل الأحمال المكررة في بيئة التعافي
أفضل استخدام#
BaaS: استعادة الملفات، الأرشفة، والامتثال
DRaaS: تعطل الموقع، التعافي السيبراني، والـFailover السريع
النسخ الاحتياطي يحافظ على نقاط استعادة تاريخية واحتفاظ طويل الأجل.
DRaaS يُبقي الأحمال قريبة من حالة تشغيل قابلة للاستعادة بسرعة.
النسخ الاحتياطي مناسب لاستعادة الملفات، والأرشفة، والامتثال.
DRaaS مصمم لاستمرارية التطبيقات، والـFailover، والاستعادة السريعة.
النسخ الاحتياطي يحمي تاريخ البيانات، بينما DRaaS يحمي القدرة على استئناف التشغيل.
5. اختر نموذج النسخ المتماثل المناسب#
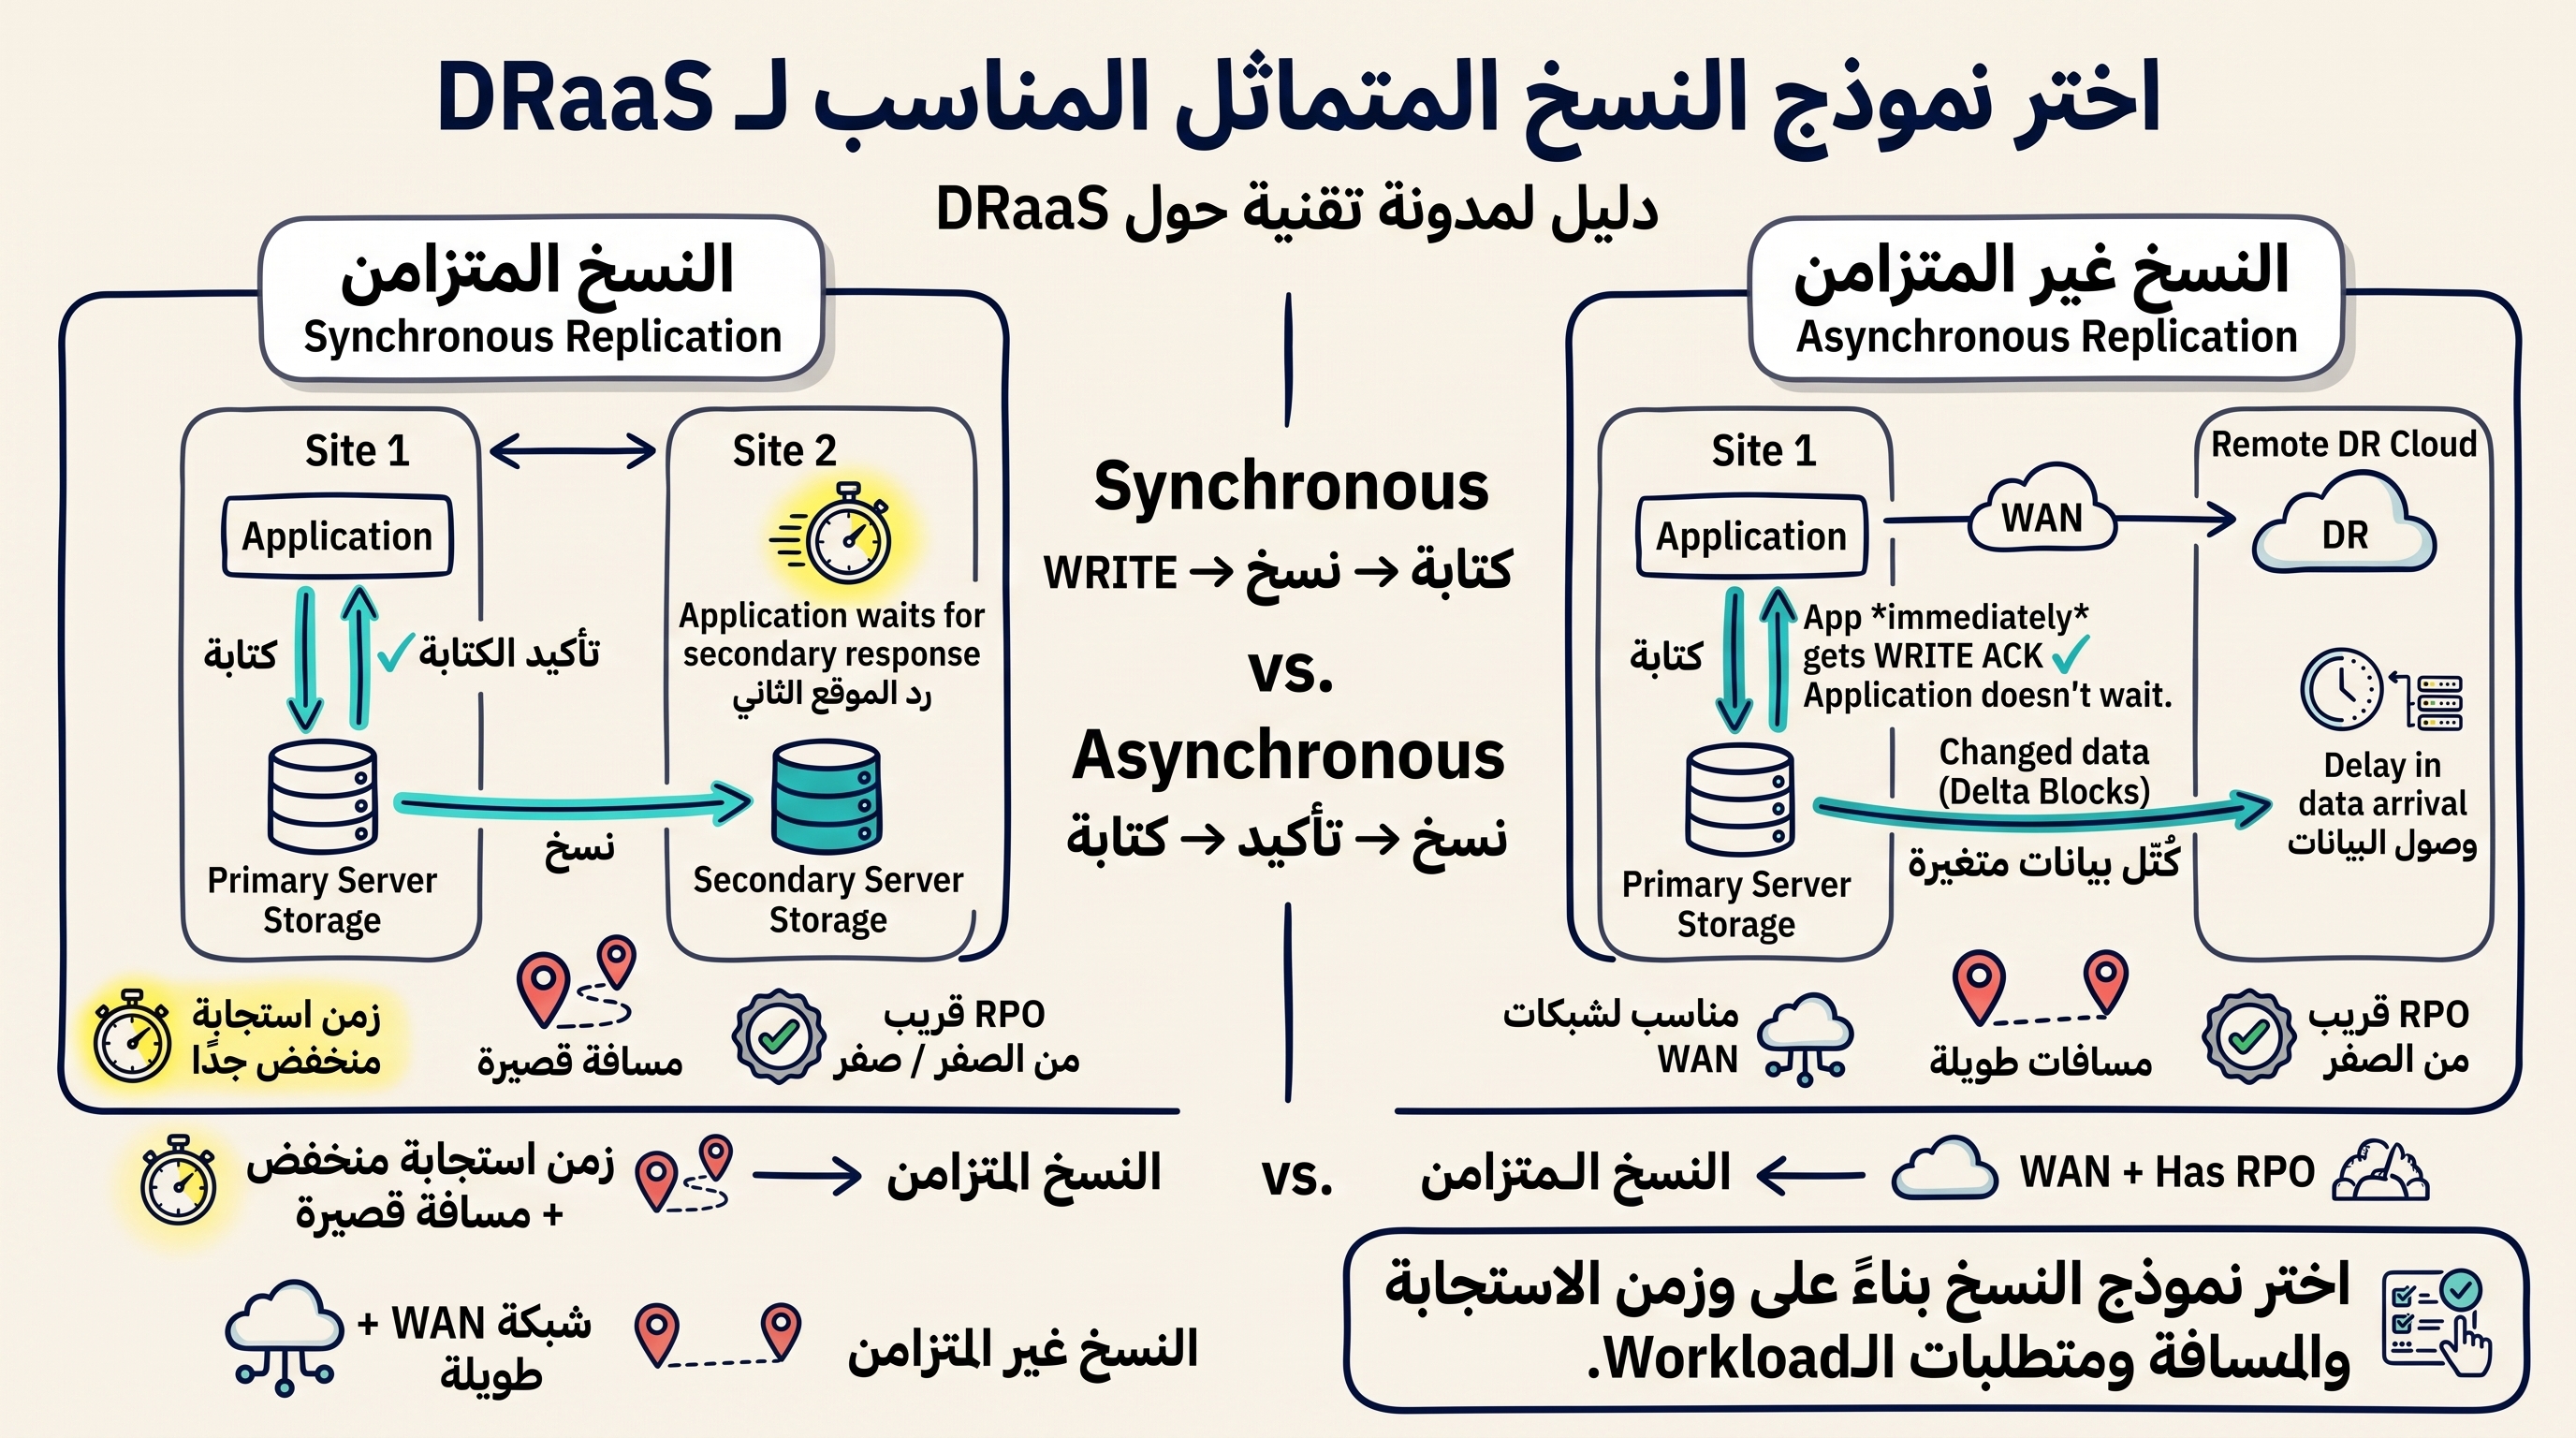
طريقة توقيت النسخ المتماثل تؤثر مباشرةً في زمن الاستجابة، والمسافة، ومقدار فقدان البيانات المحتمل.
النسخ المتزامن يمكن أن يستهدف RPO قريبًا من الصفر أو صفرًا، لكنه يحتاج إلى زمن استجابة منخفض جدًا.
النسخ غير المتزامن أنسب لروابط WAN والمسافات الجغرافية الطويلة.
يجب أن يتوافق تصميم النسخ مع معدل تغيّر البيانات وهدف الاستعادة.
ينبغي تقييم عرض النطاق، وزمن الاستجابة، والمسافة معًا.
أسرع نموذج نسخ ليس دائمًا أفضل بنية للمؤسسة.
6. اختر الطبقة التي يتم عندها النسخ#
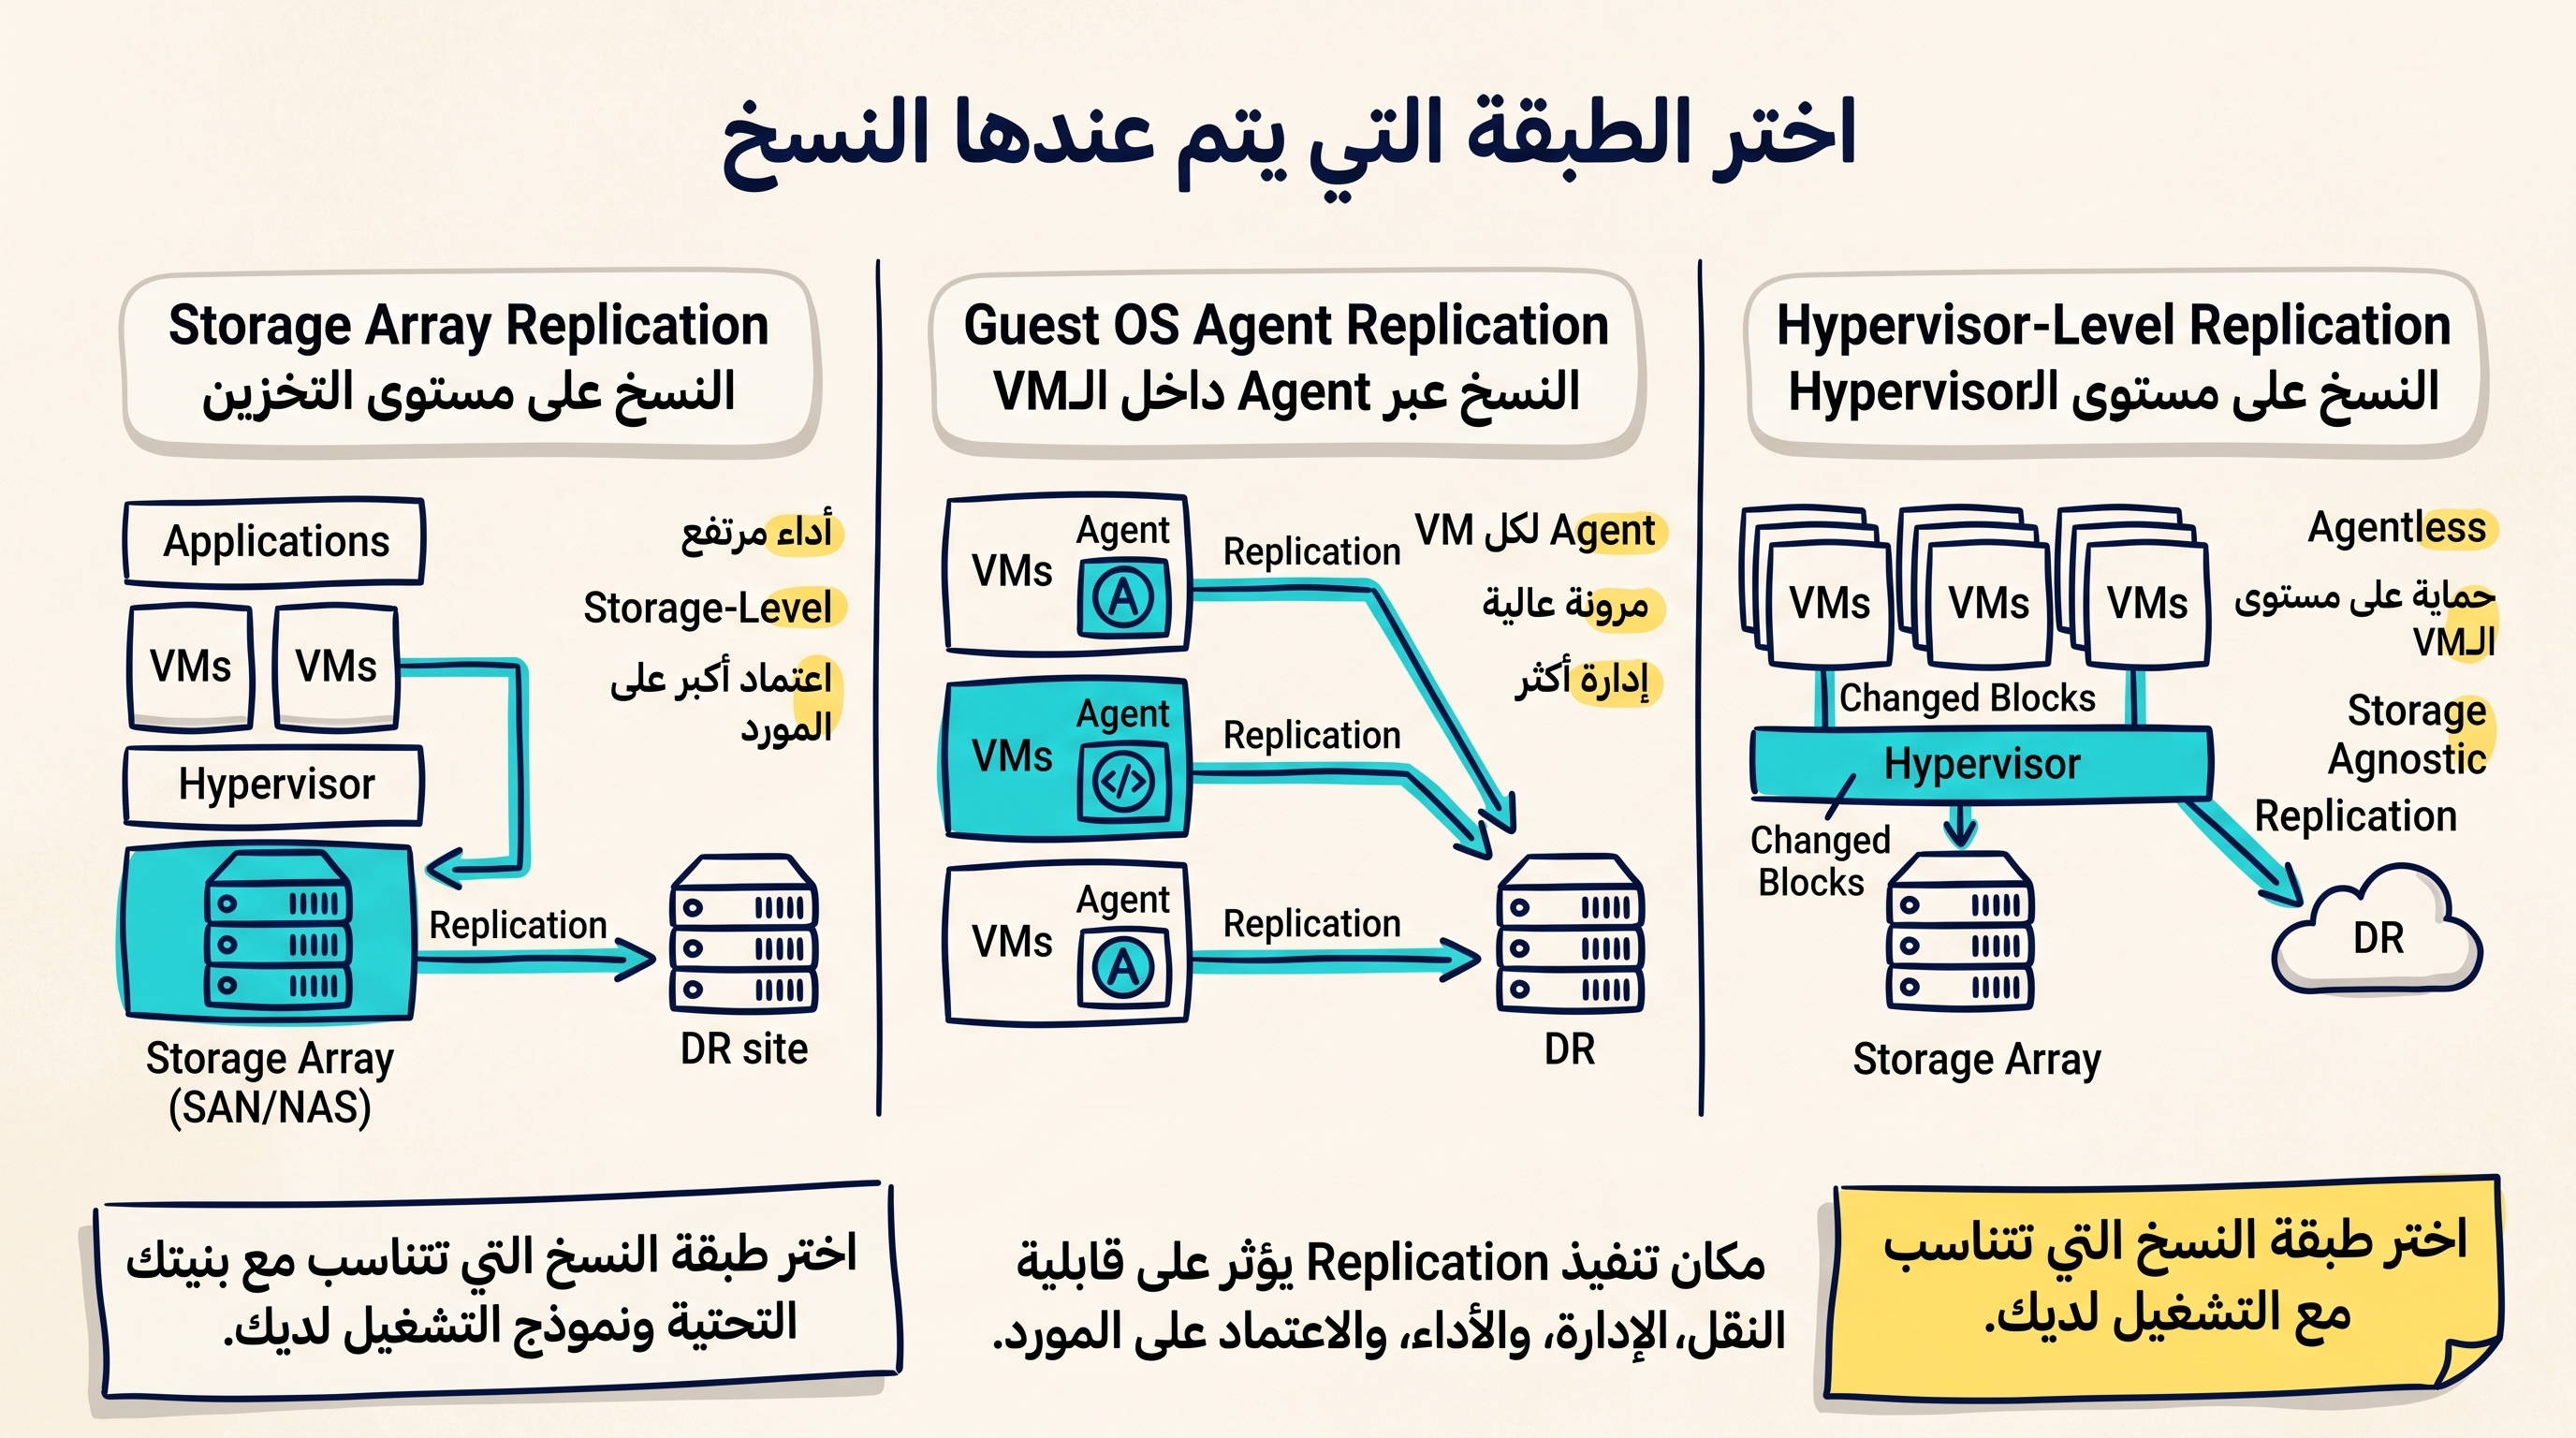
يمكن تنفيذ النسخ على مستوى التخزين، أو داخل نظام التشغيل الضيف، أو على مستوى الـHypervisor.
النسخ على مستوى مصفوفة التخزين يوفر تكاملًا عميقًا لكنه قد يزيد الاعتماد على مورد محدد.
النسخ عبر Agent داخل نظام التشغيل يعمل عبر بيئات متنوعة لكنه يضيف عبئًا تشغيليًا.
النسخ على مستوى الـHypervisor يحمي الـVMs دون الحاجة إلى Agent داخل كل جهاز افتراضي.
اختيار الطبقة المناسبة يعتمد على البنية الحالية ونموذج التشغيل وقابلية النقل.
اختر طبقة نسخ تتناسب مع البنية التحتية ومع طريقة إدارة البيئة اليومية.
7. اختر موقع التعافي المناسب#
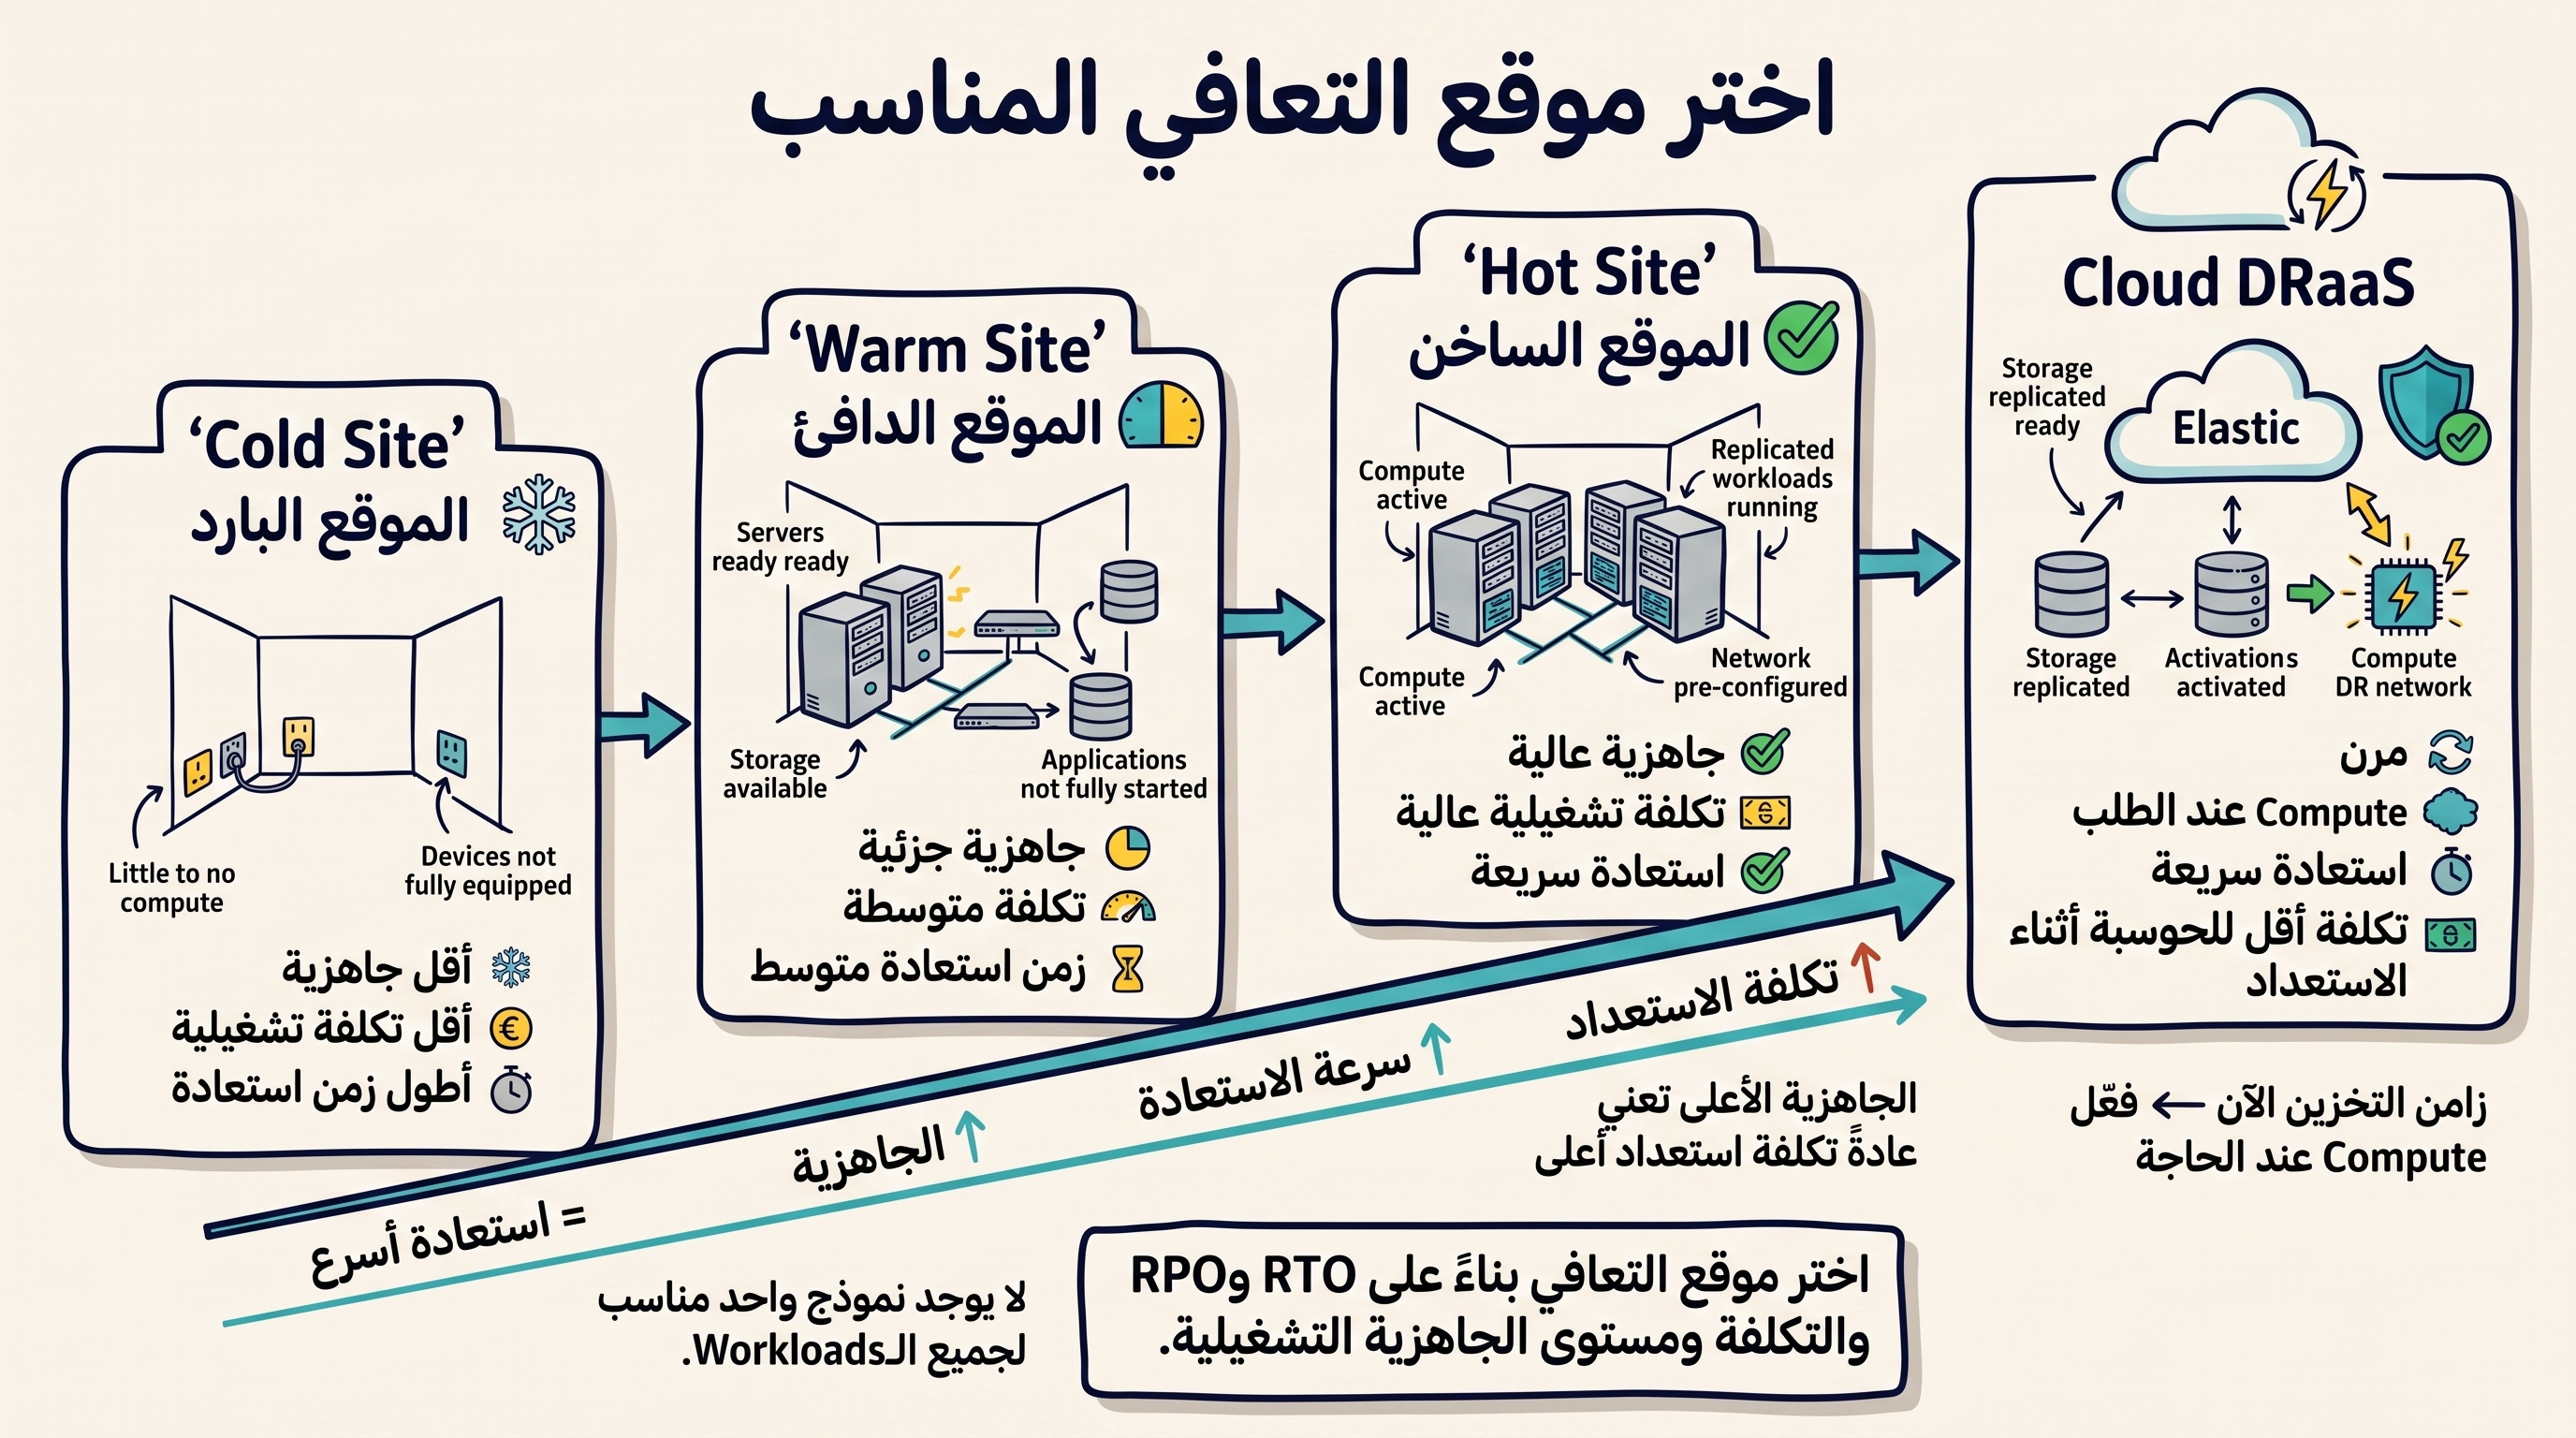
تتدرج مواقع التعافي من مواقع باردة منخفضة التكلفة إلى مواقع ساخنة جاهزة بالكامل، وصولًا إلى DRaaS السحابي المرن.
الموقع البارد يقلل تكلفة الاستعداد لكنه يرفع زمن الاستعادة.
الموقع الدافئ يحتفظ بجزء من البنية جاهزًا لكنه لا يزال يحتاج إلى استعادة أو تفعيل.
الموقع الساخن يحقق استعادة أسرع مقابل تكلفة تشغيلية مستمرة أعلى.
DRaaS السحابي يمكن أن يُبقي التخزين متزامنًا ويُفعّل الحوسبة فقط عند الحاجة.
كلما ارتفعت سرعة التعافي المطلوبة، ارتفعت عادةً تكلفة الاستعداد.
8. خطط لتعافي الشبكة بنفس دقة تعافي الـVMs#
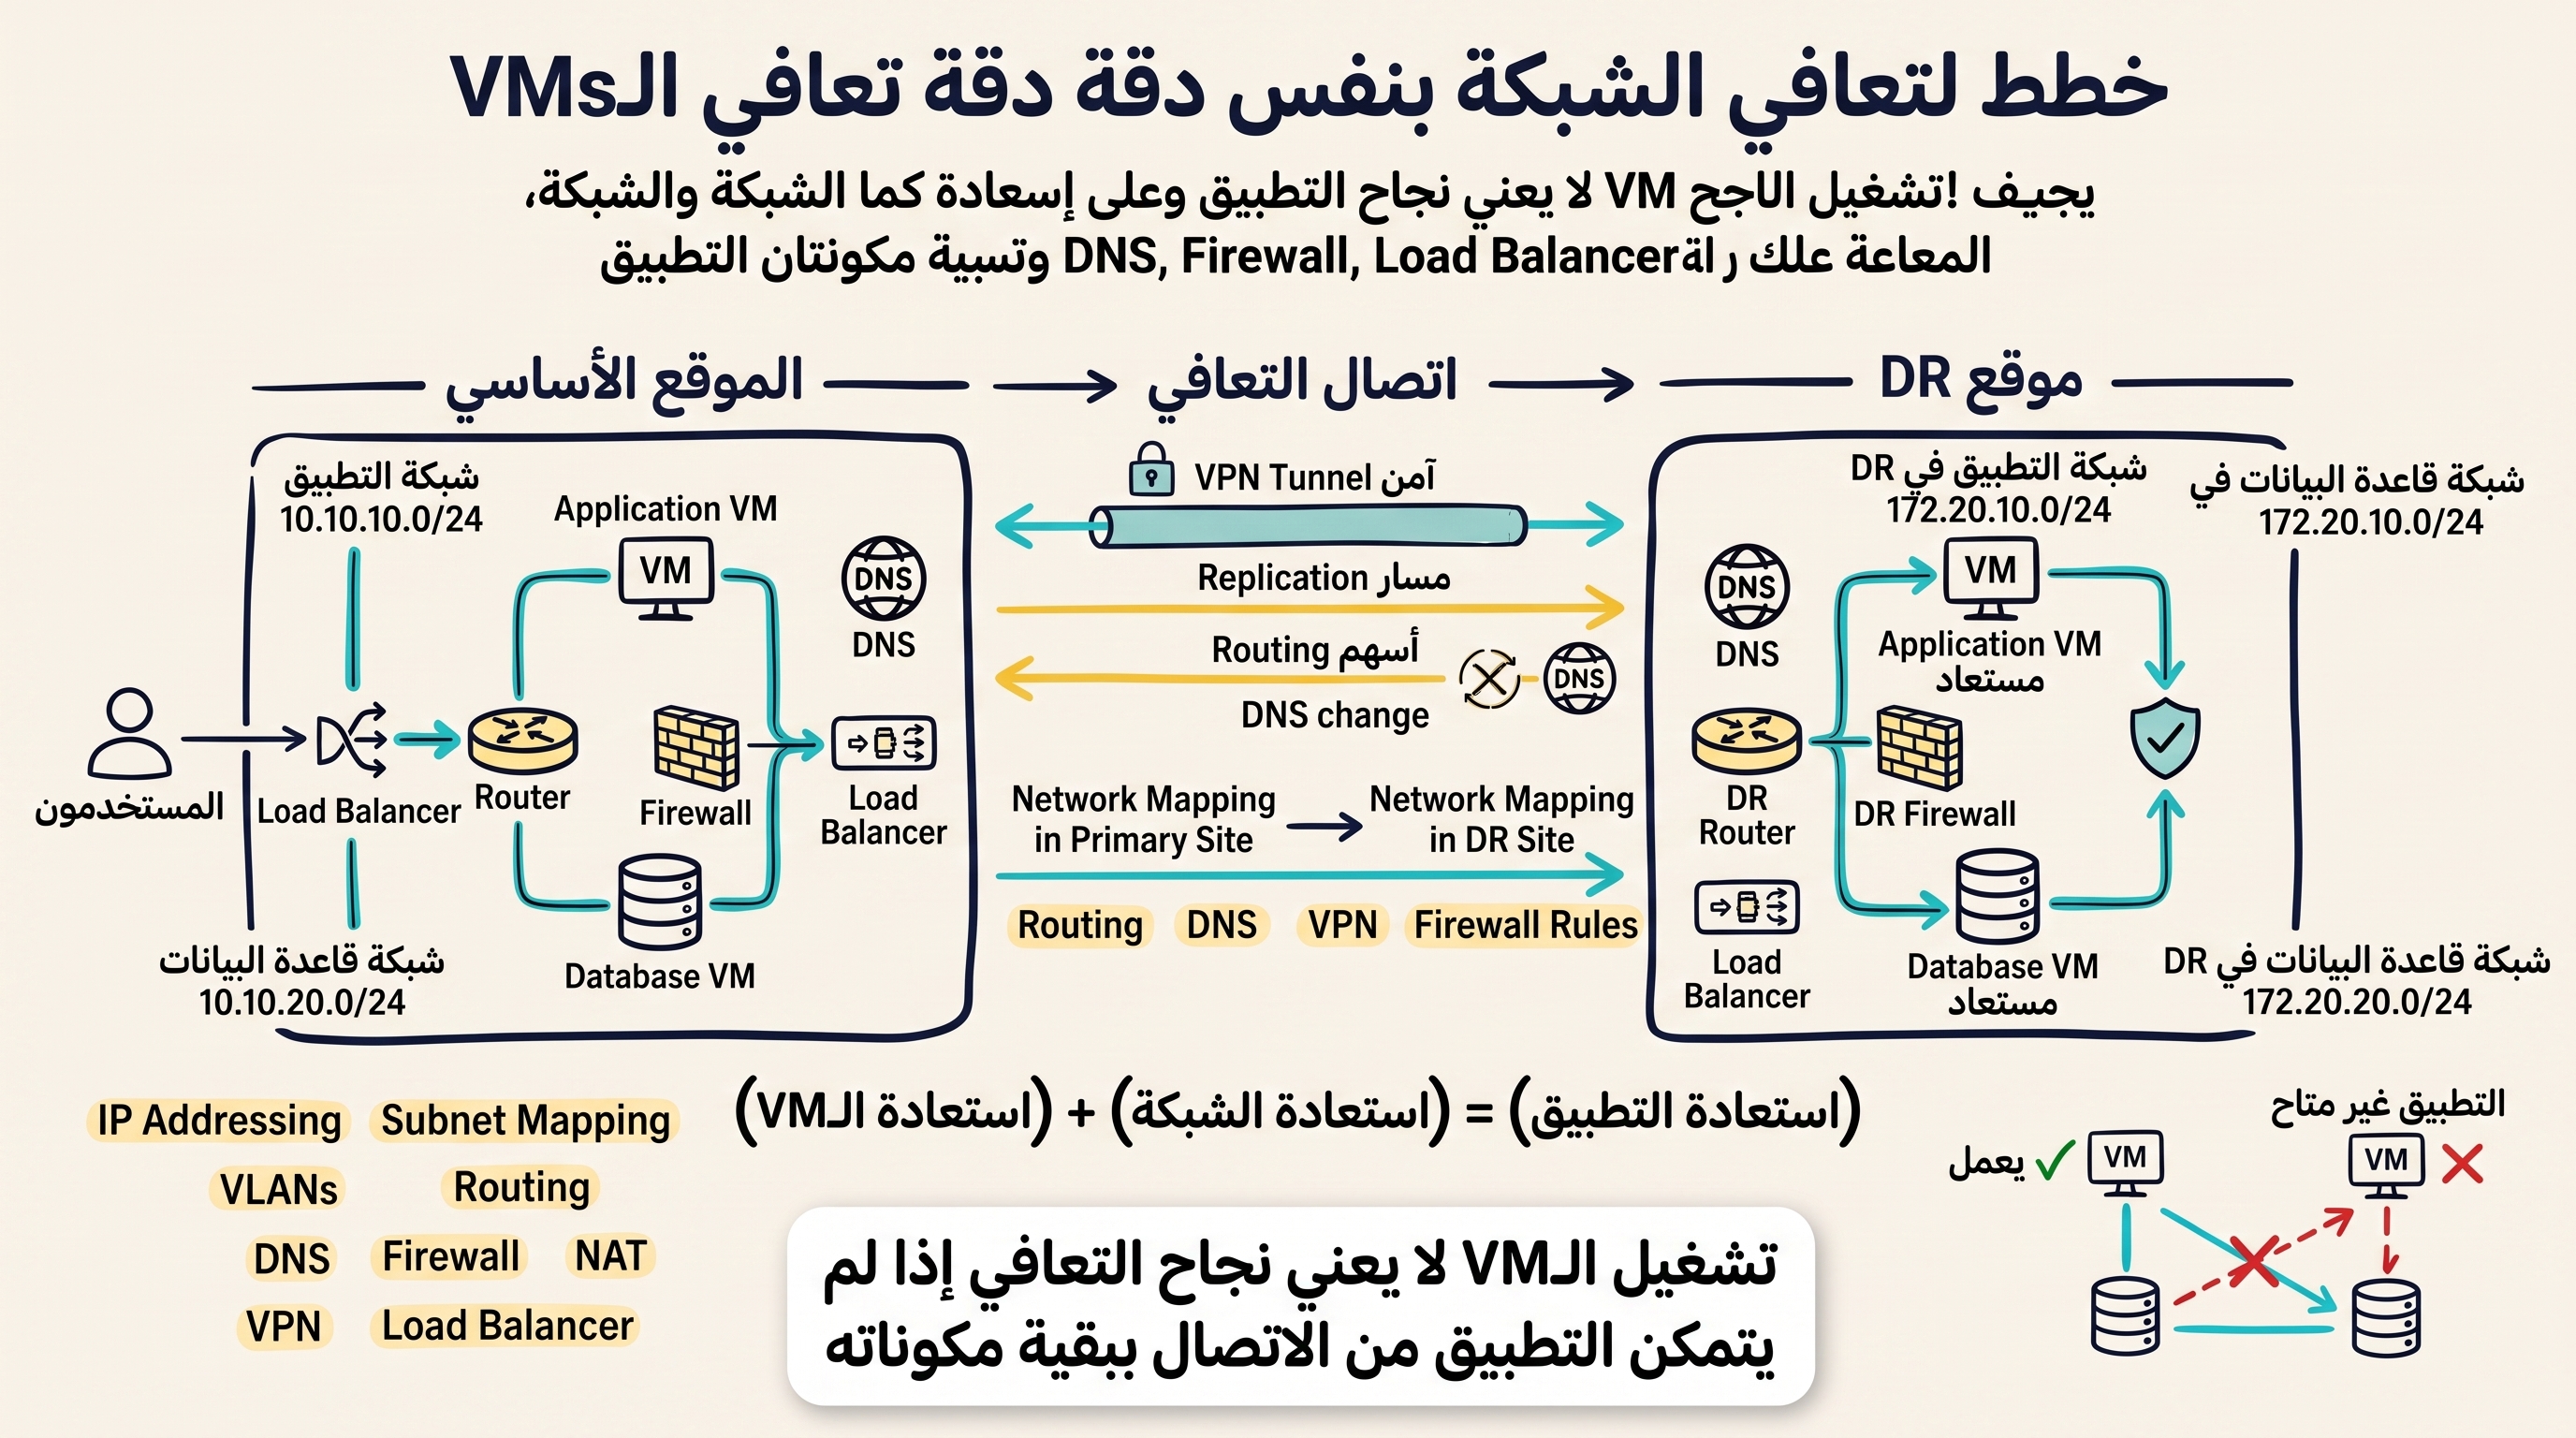
تفشل كثير من اختبارات DR لأن الأجهزة الافتراضية تعمل، لكن الشبكة لا تعمل بالشكل المطلوب.
تغيّر عناوين IP وربط الشبكات الفرعية
VLANs والمسارات Routing
تحديثات DNS
NAT وقواعد الجدران النارية
موازنات الأحمال وVPN
Security Groups والاعتماديات الخارجية
تشغيل الـVM بنجاح لا يعني أن التطبيق تعافى إذا لم يتمكن من الاتصال ببقية مكوناته.
9. استخدم Point-in-Time Recovery للأعطال المنطقية#
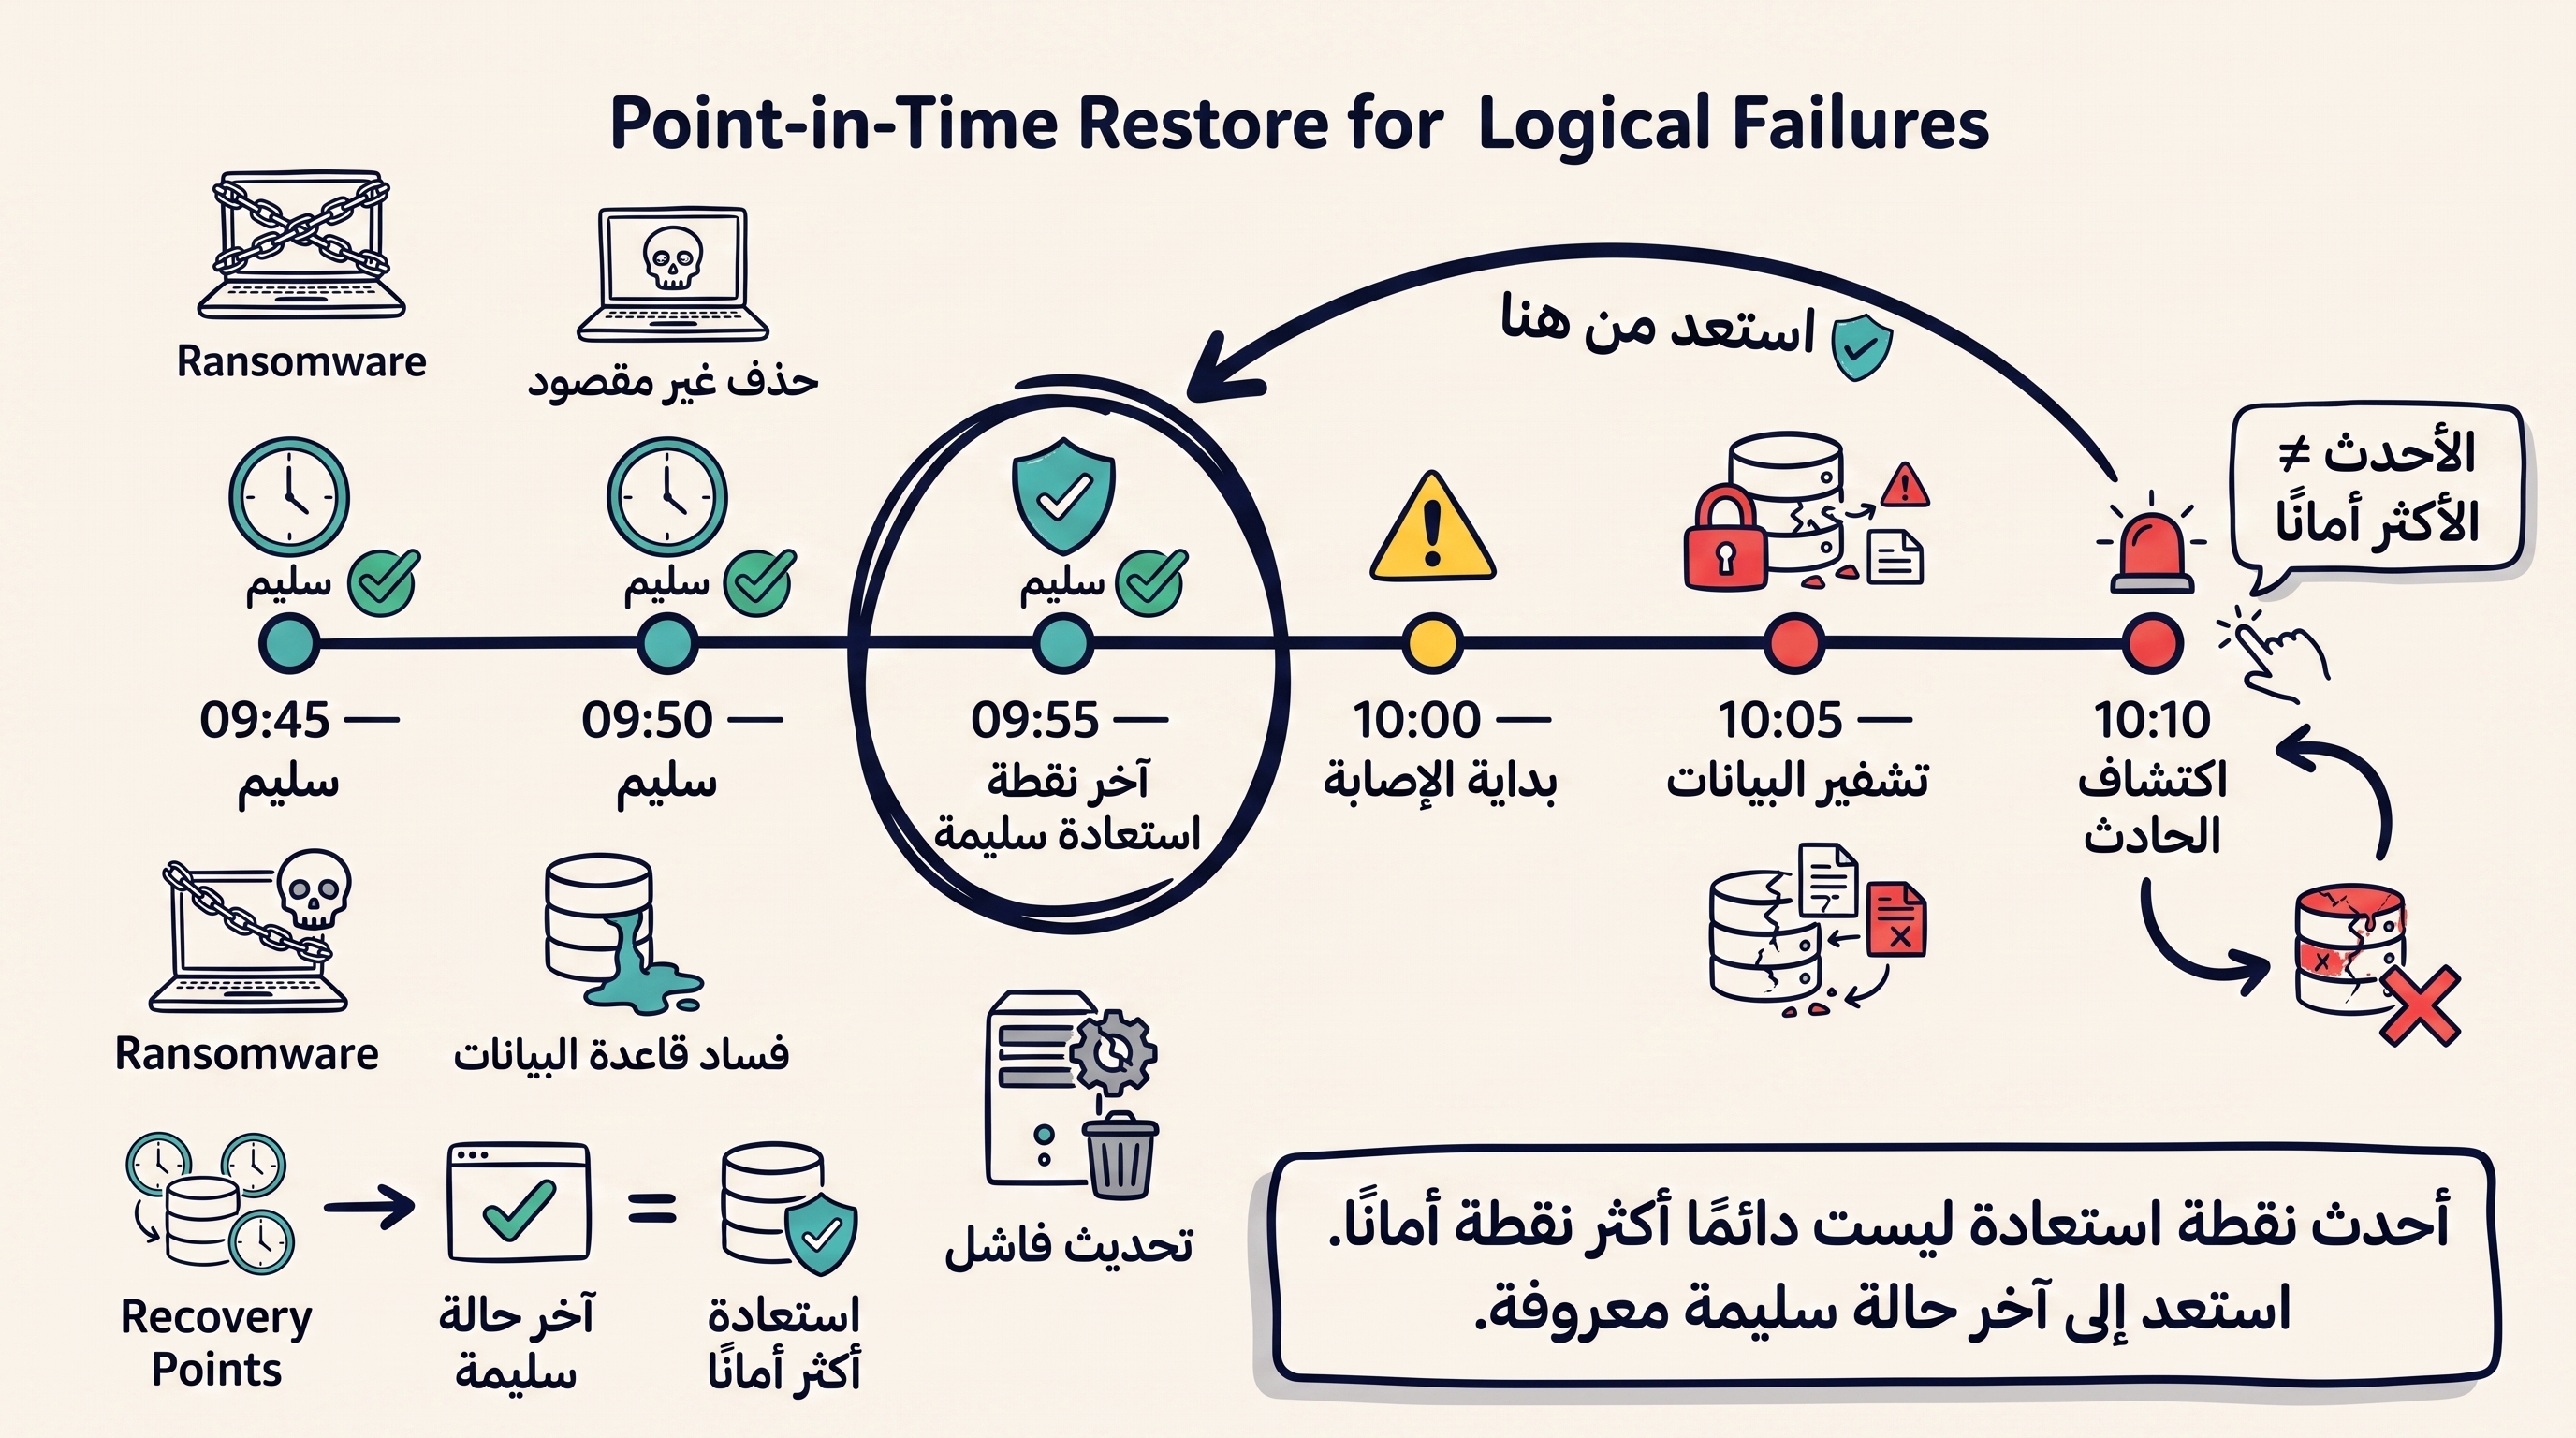
قد يقوم النسخ المتماثل بنقل الحالة الخاطئة نفسها إلى موقع DR، ولهذا تعد نقاط الاستعادة التاريخية مهمة.
برامج الفدية قد تقوم بتشفير البيانات ثم يتم نسخ التغييرات المشفرة إلى موقع DR.
التحديثات السيئة قد تفسد تطبيقًا رغم أن الـVM يعمل طبيعيًا.
تغييرات قواعد البيانات قد تتطلب الرجوع إلى نقطة أقدم.
وجود عدة Recovery Points يعطي خيارات أكثر من مجرد استعادة آخر نسخة.
أحدث نقطة استعادة ليست دائمًا أكثر نقطة أمانًا.
10. أنشئ Runbooks قبل وقوع الحادث#
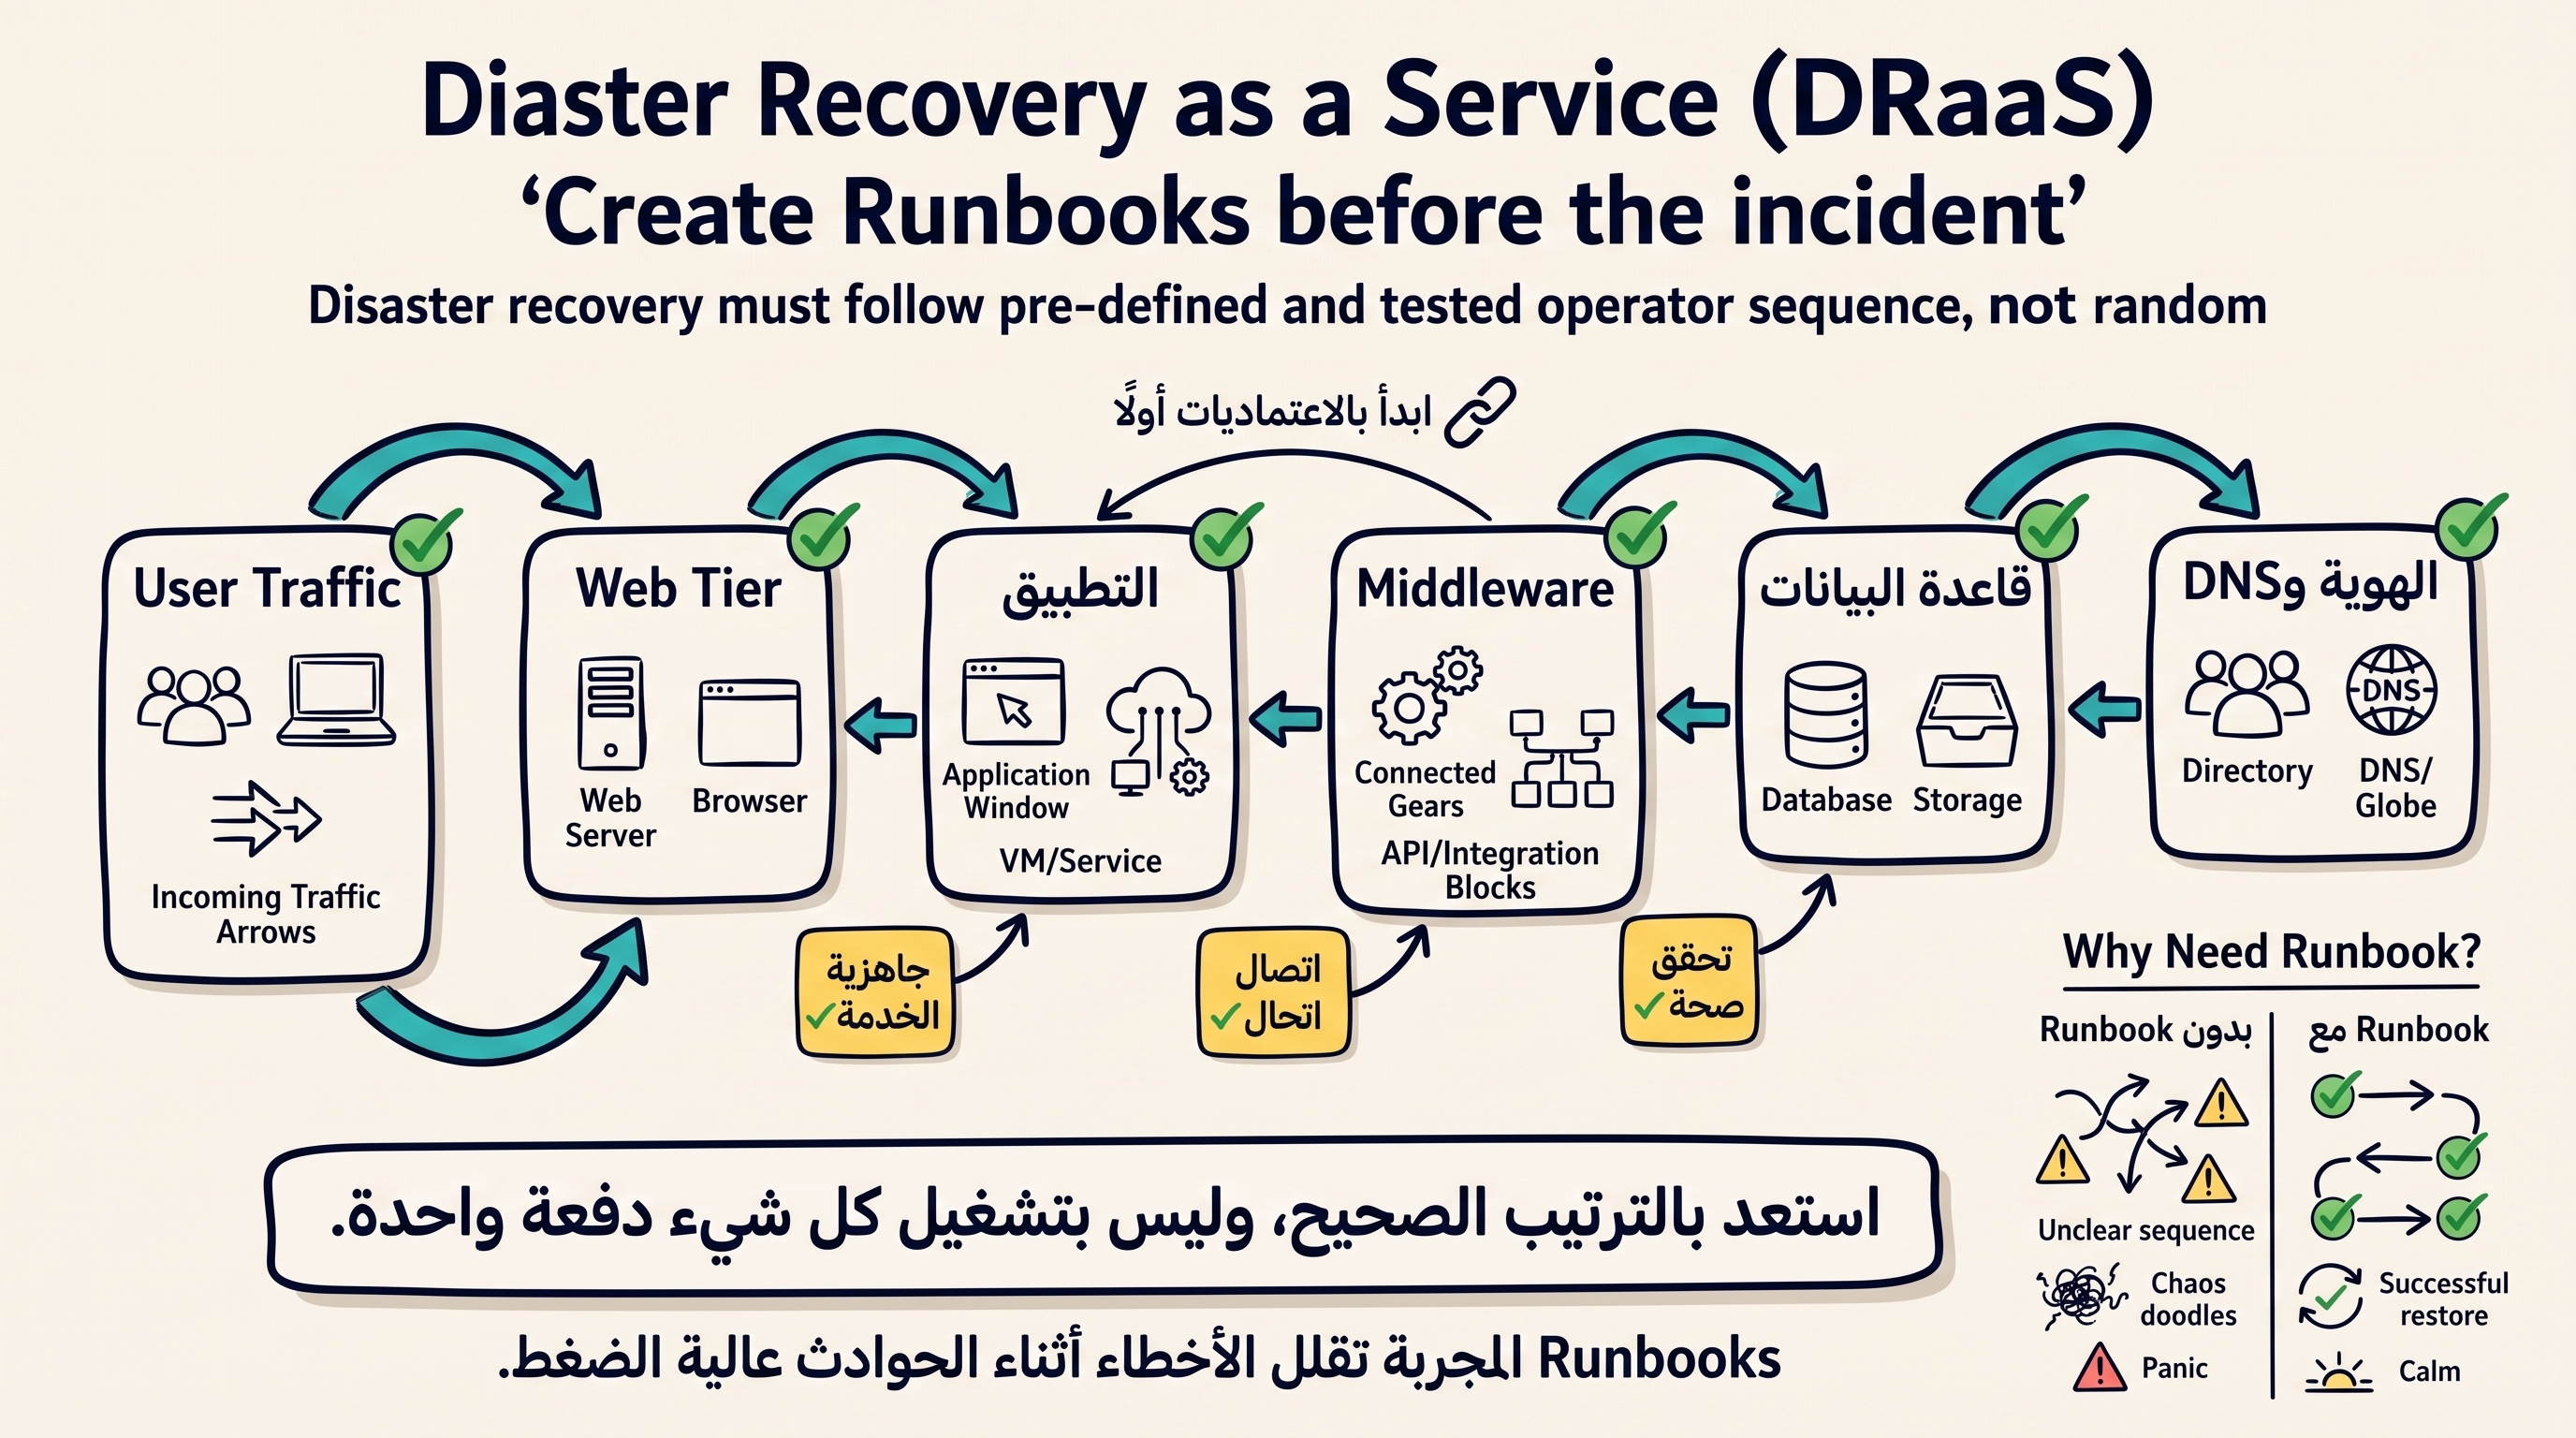
الـRunbook الجيد يحوّل التعافي إلى خطوات محددة بدلًا من الارتجال تحت الضغط.
Identity / DNS
      ↓
Database
      ↓
Middleware
      ↓
Application
      ↓
Web / User Access
فعّل شبكات DR.
شغّل خدمات الهوية وDNS والبنية الأساسية.
شغّل قواعد البيانات قبل التطبيقات التي تعتمد عليها.
طبّق تغييرات Routing وDNS.
نفّذ اختبارات صحة قبل إعادة توجيه المستخدمين.
وثّق المسؤوليات والموافقات ومسارات التصعيد.
أثناء الانقطاع، Runbook مجرّب أهم بكثير من خطة مرتجلة.
11. احمِ بيئة التعافي نفسها#
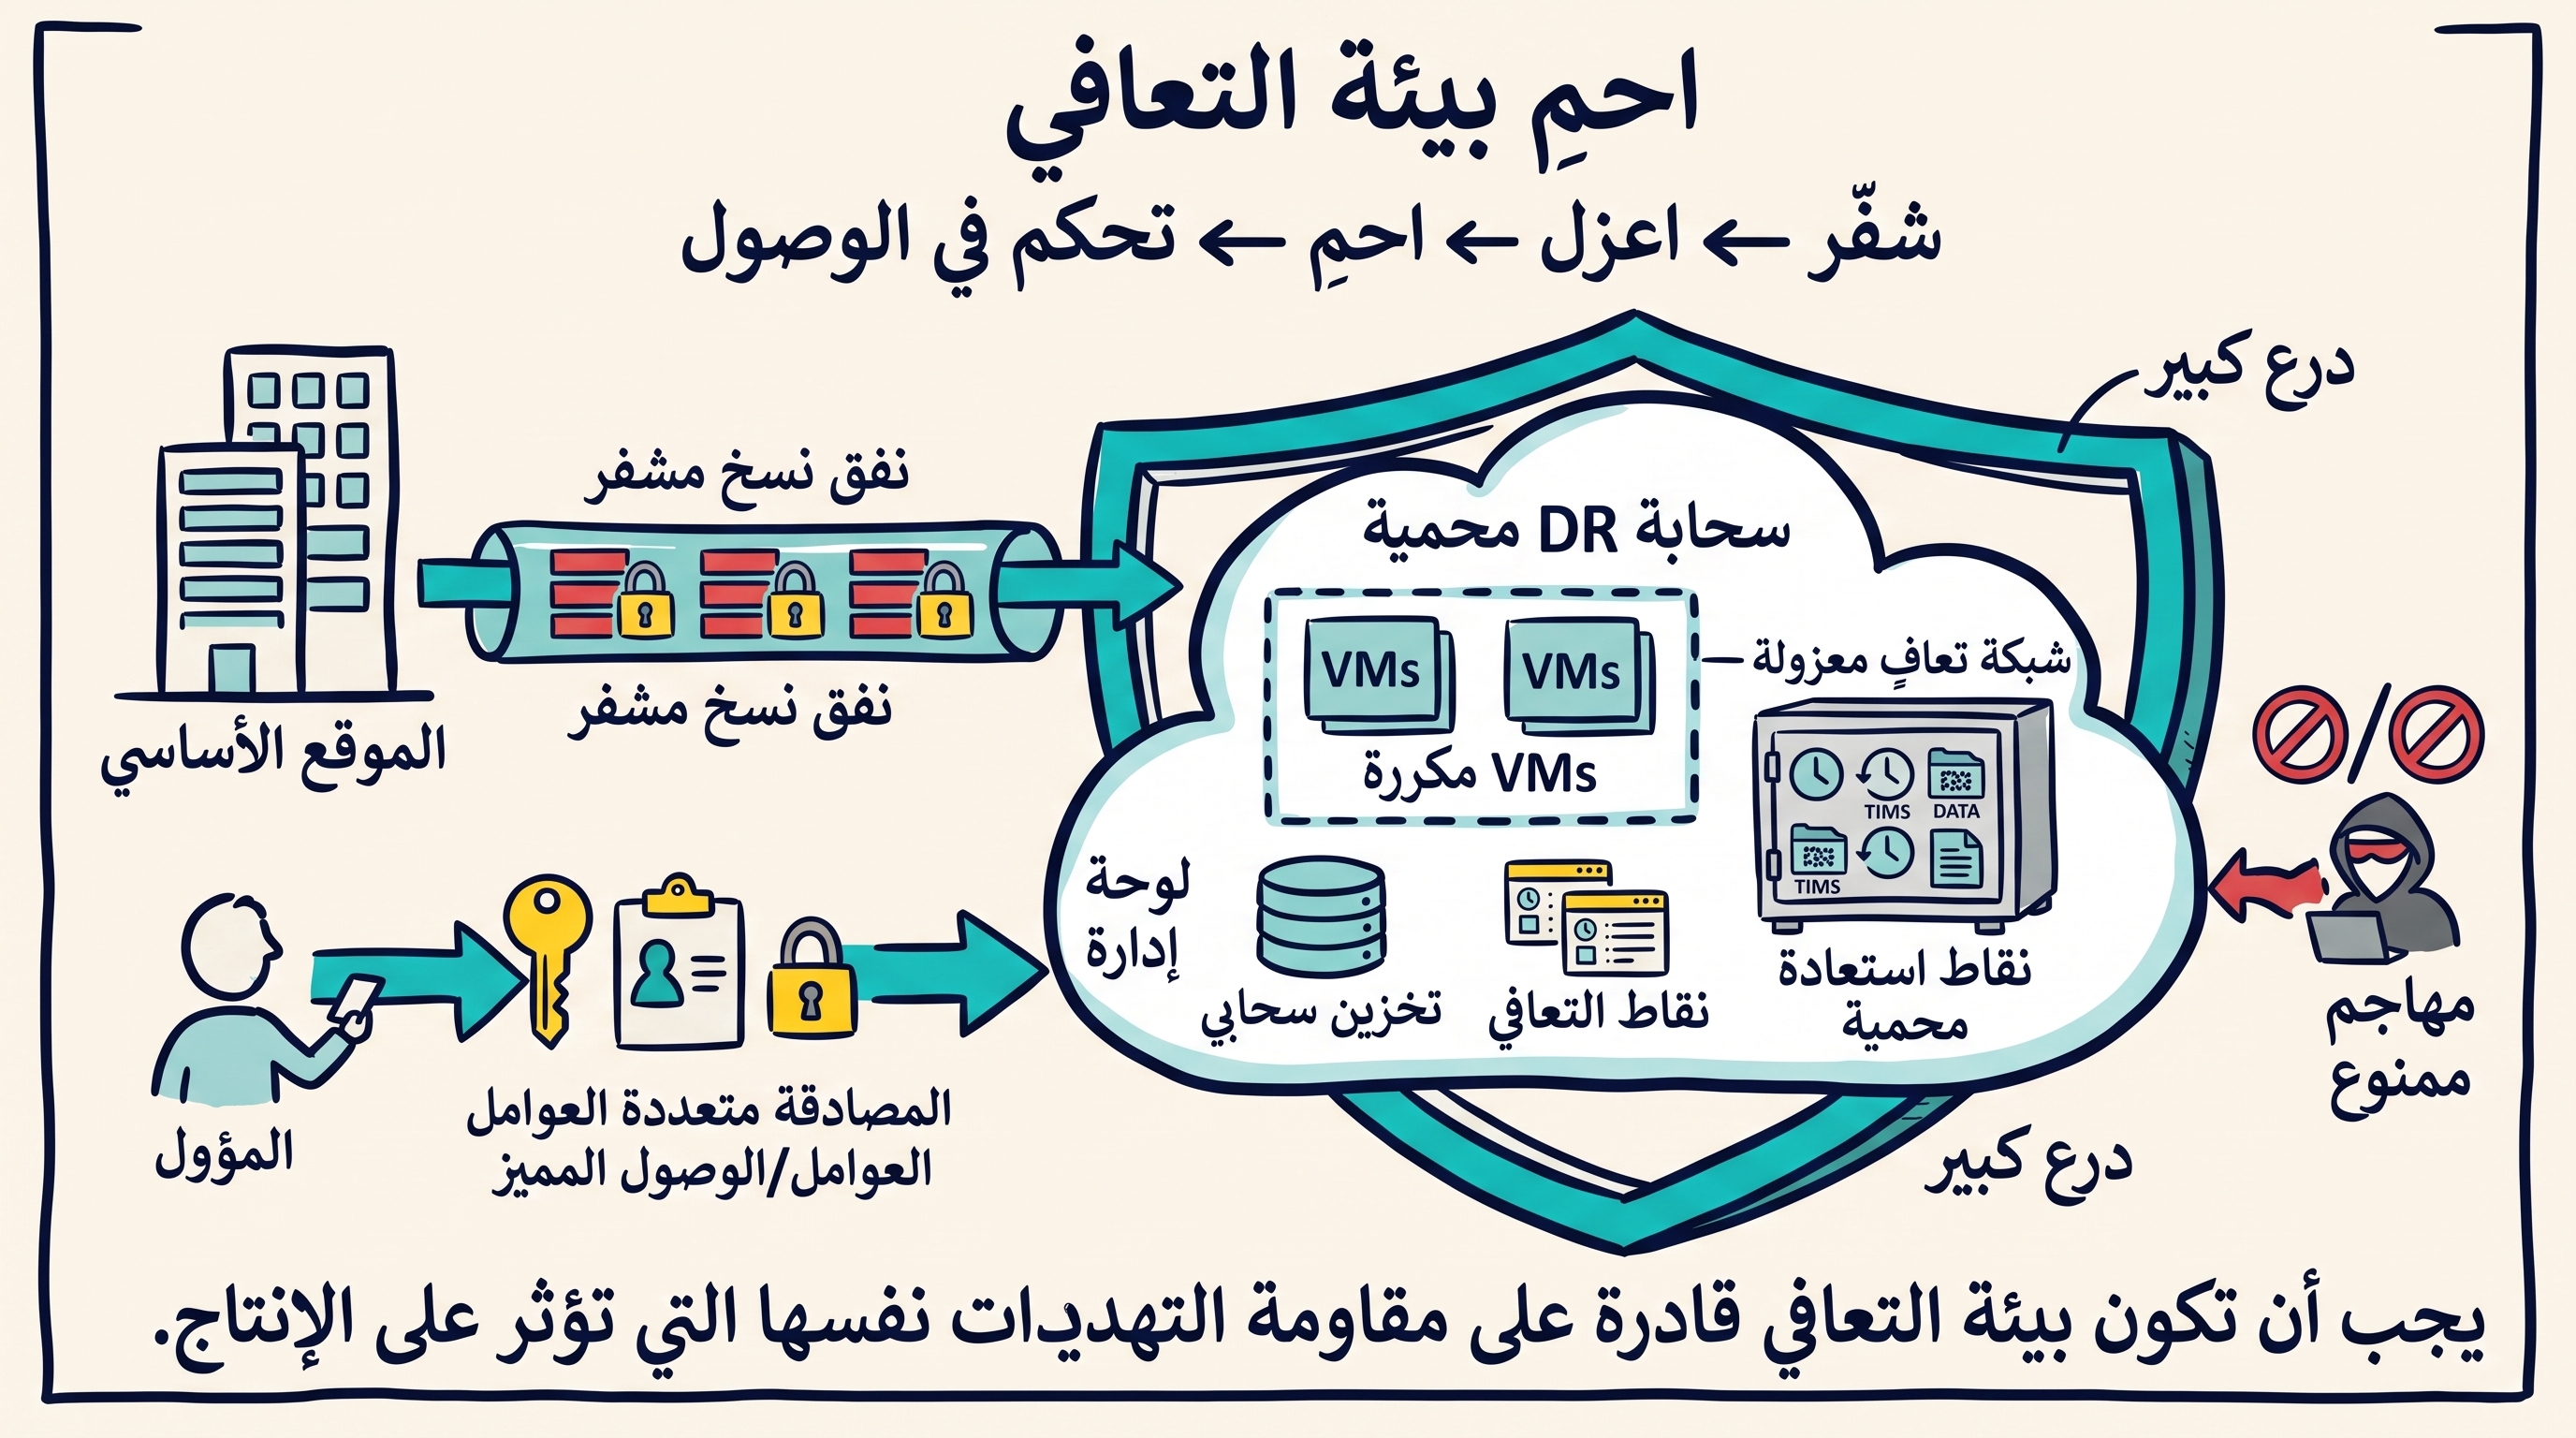
يجب ألا تصبح بيئة DR المسار الأسهل للمهاجم مقارنةً ببيئة الإنتاج.
استخدم التشفير أثناء النقل وأثناء التخزين.
افصل صلاحيات إدارة DR عن صلاحيات الإنتاج حيثما كان ذلك عمليًا.
احمِ نقاط الاستعادة من الحذف غير المصرح به.
استخدم شبكات معزولة للتحقق من التعافي السيبراني.
راجع الجدران النارية والهوية والصلاحيات الإدارية في موقع DR.
منصة التعافي يجب أن تكون محمية من التهديدات نفسها التي تحاول حماية الإنتاج منها.
12. اختبر التعافي دون التأثير على الإنتاج#
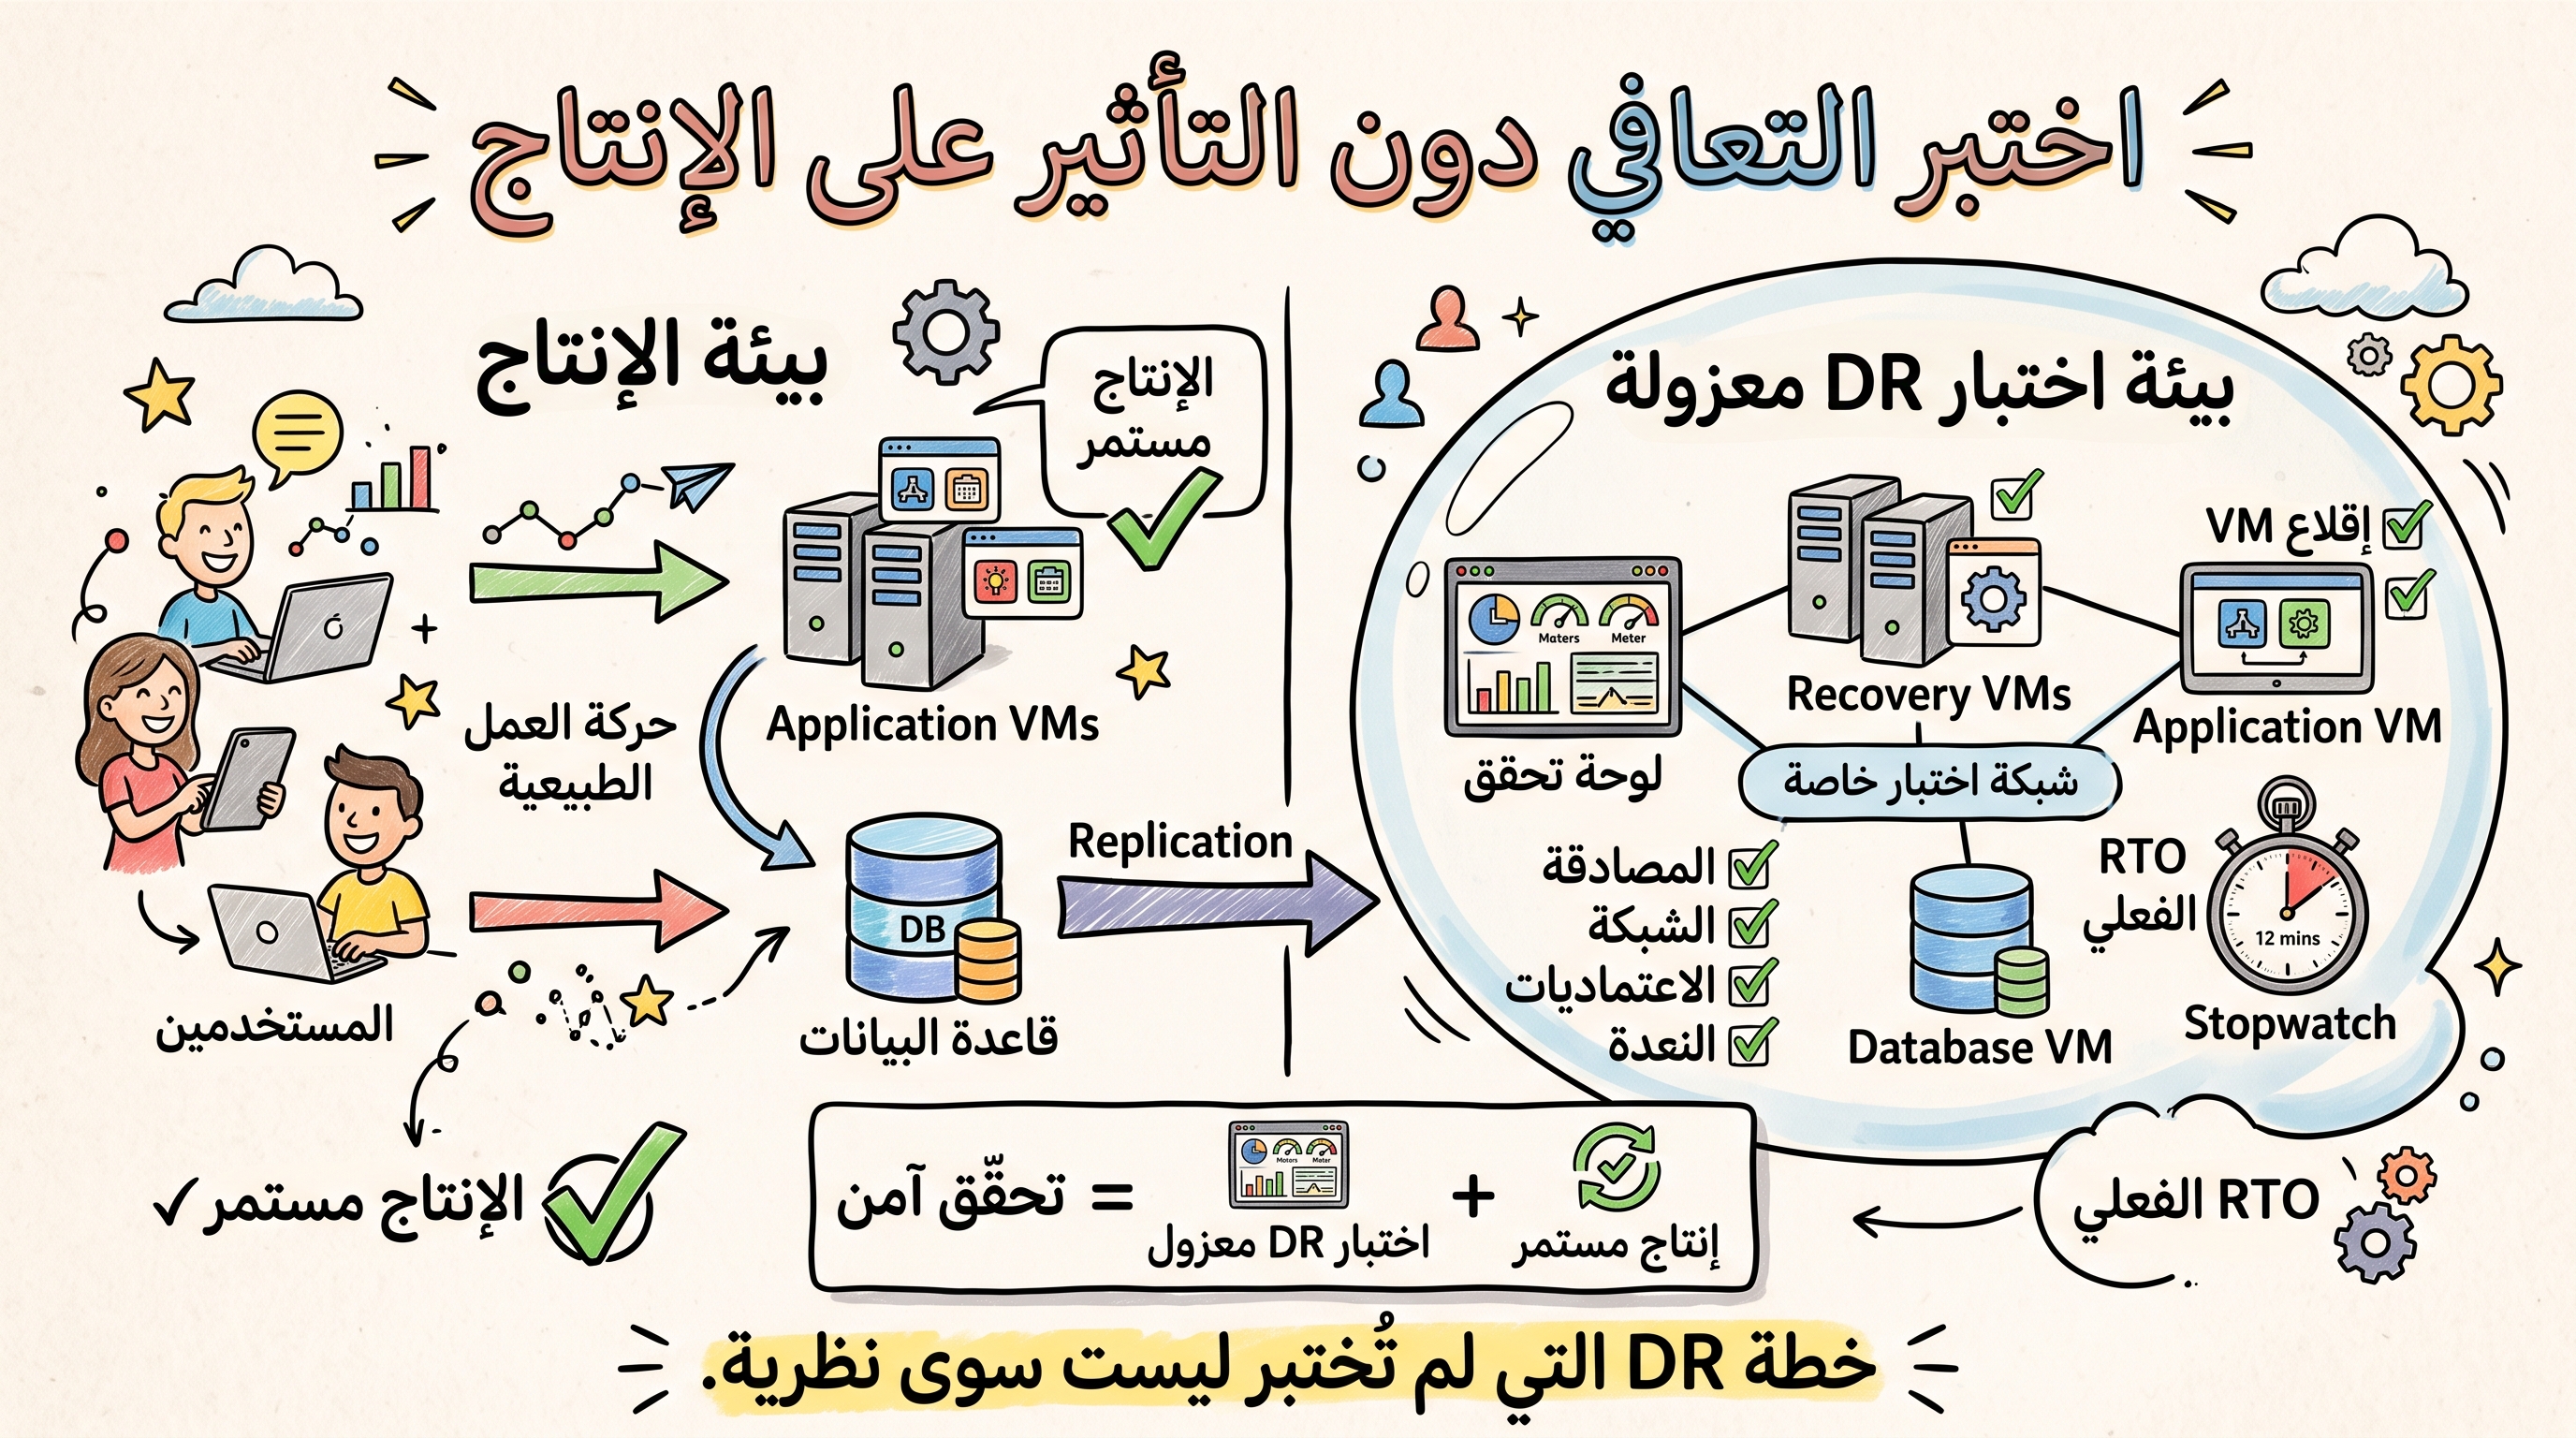
يجب أن يثبت الاختبار أن الأحمال يمكن استعادتها دون الحاجة إلى انقطاع فعلي.
شغّل النسخ في شبكات اختبار معزولة.
تحقق من إقلاع الـVMs وتشغيل التطبيقات.
تحقق من اتساق قواعد البيانات والمصادقة.
اختبر الاعتماديات الشبكية والتكاملات الخارجية.
قِس زمن التعافي الفعلي وقارنه بـRTO الموثق.
خطة DR التي لم تُختبر بعد ليست سوى نظرية.
13. خطط للـFailback قبل أن تنفذ Failover#
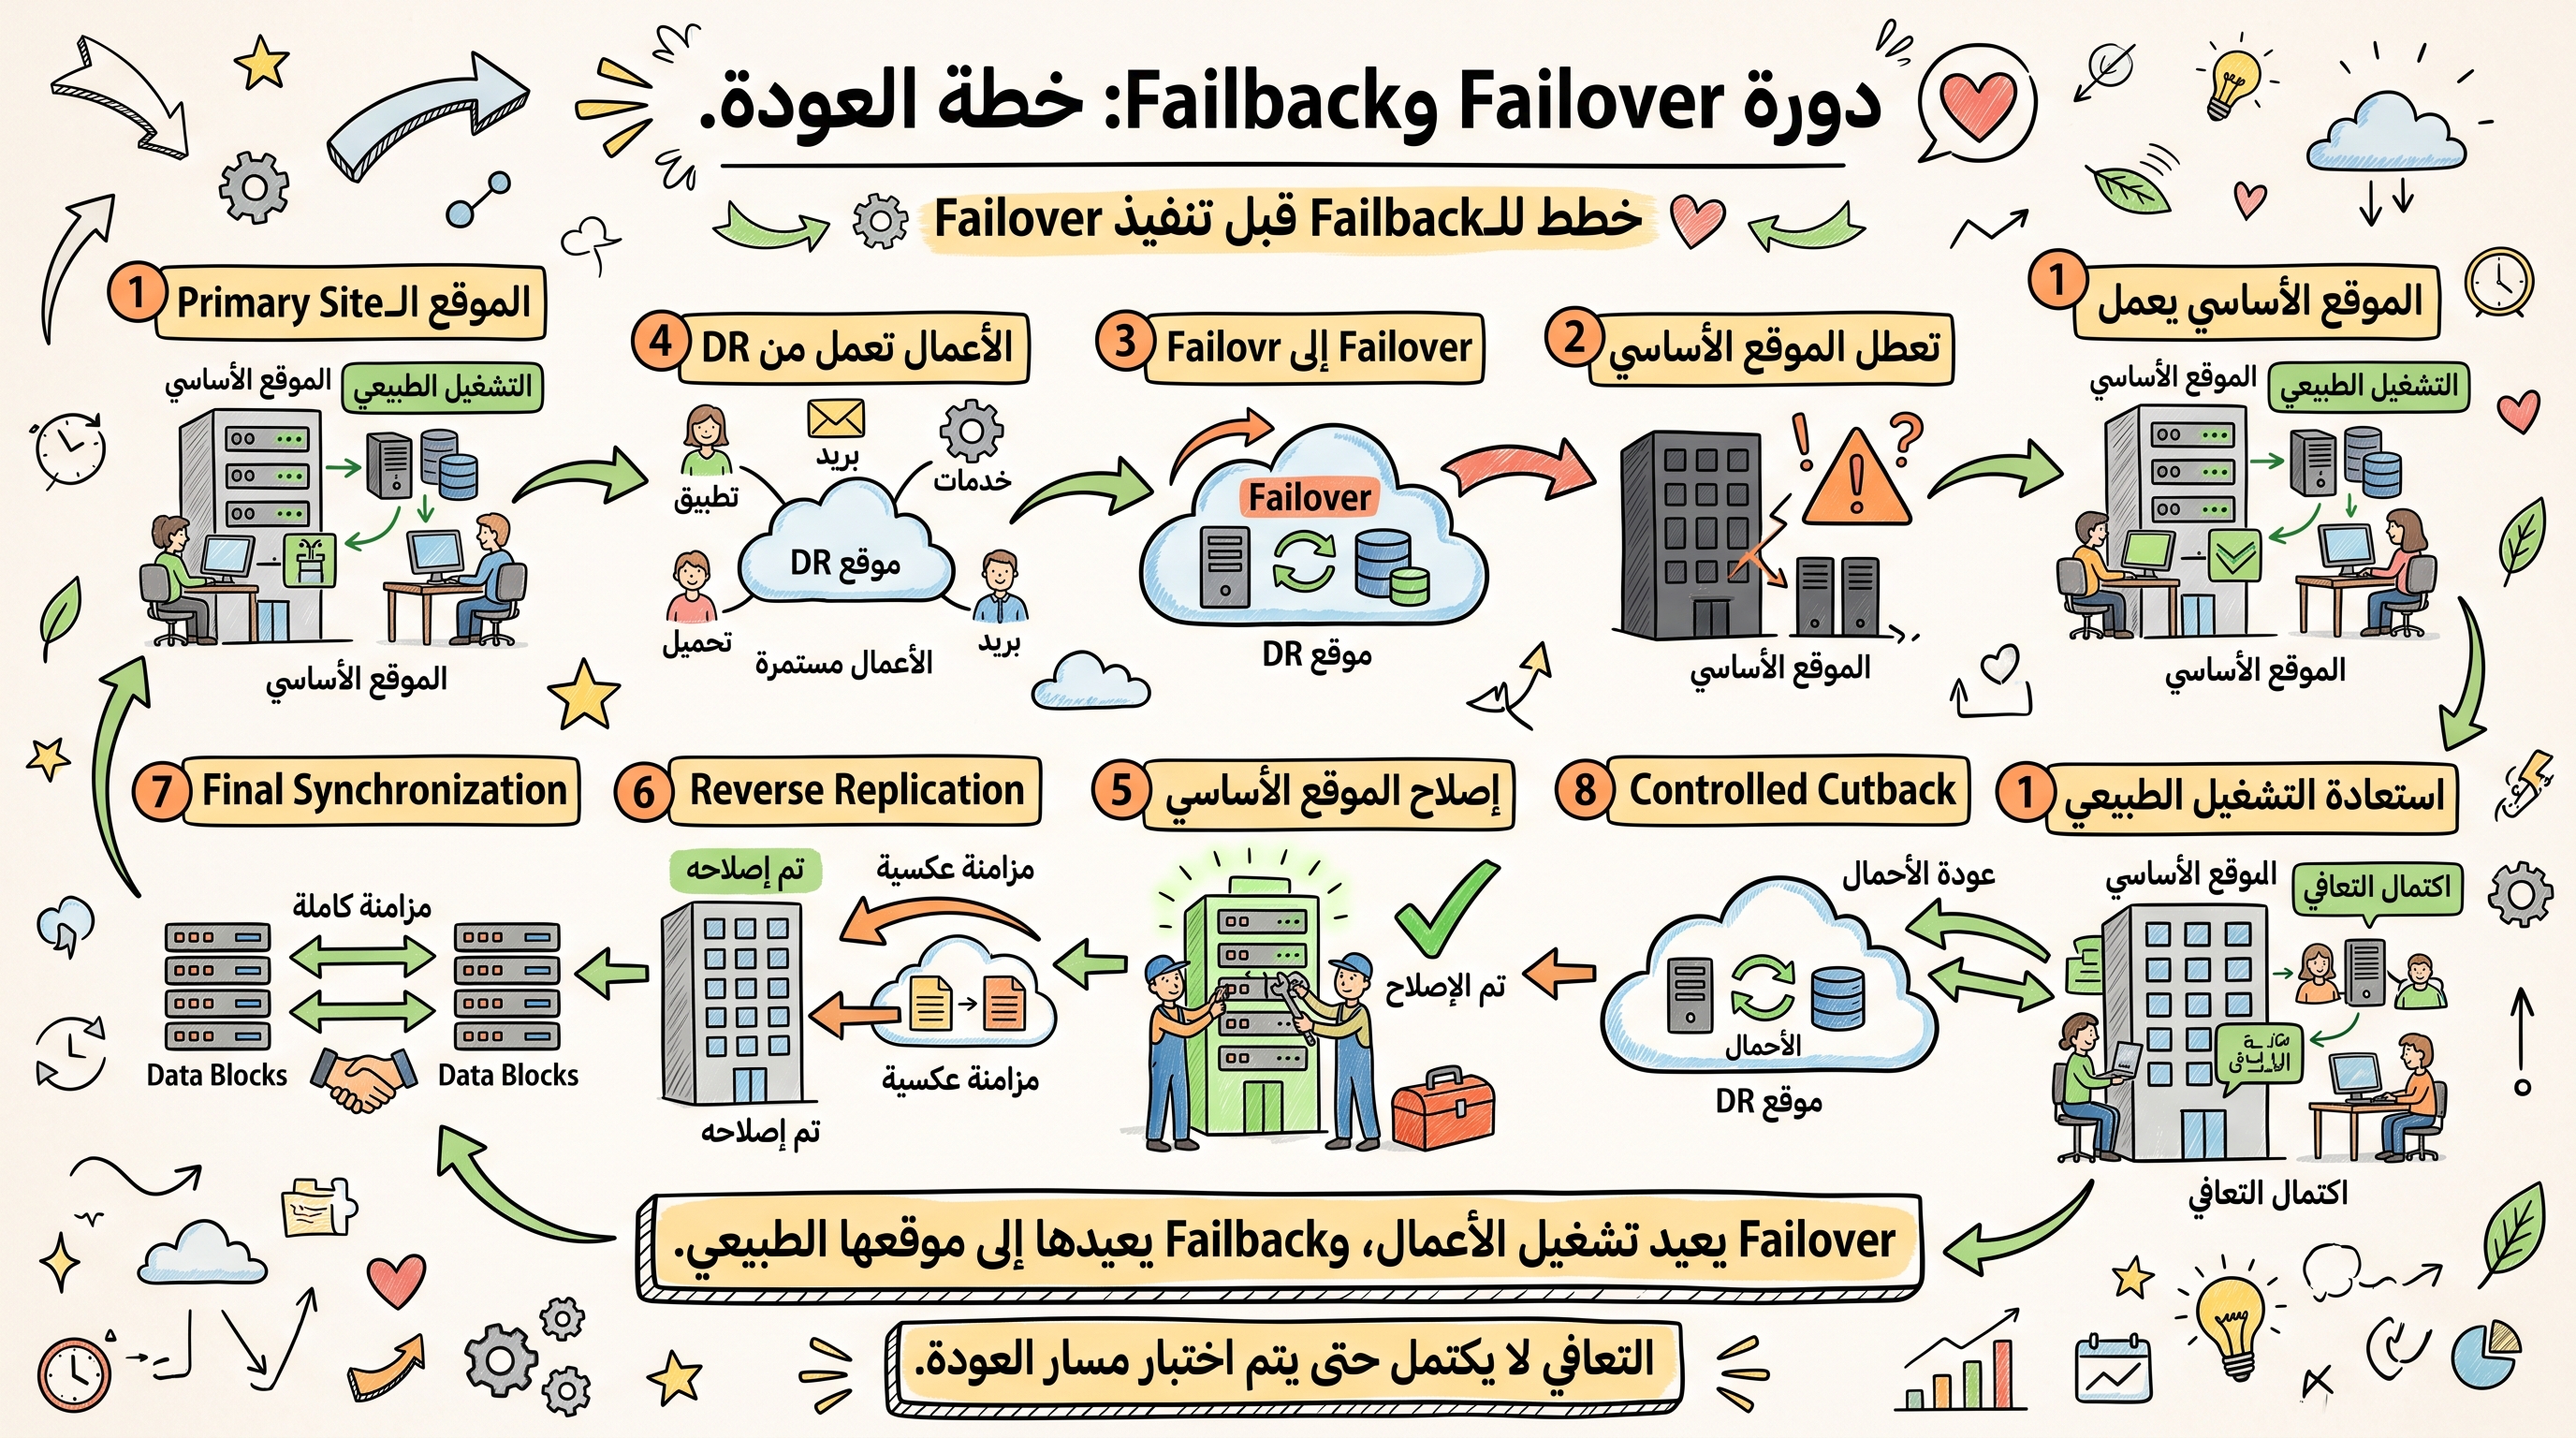
الـFailover هو نصف العملية فقط؛ ففي النهاية يجب إعادة الأحمال إلى الموقع الأساسي بعد إصلاحه.
Primary Site Fails
        ↓
DR Site Activated
        ↓
Business Runs in DR
        ↓
Primary Site Repaired
        ↓
Changes Replicated Back
        ↓
Controlled Cutback
أصلح الموقع الأساسي وتحقق من جاهزيته.
أعد إنشاء النسخ أو اعكس اتجاهه.
زامن التغييرات التي حدثت أثناء التشغيل في DR.
حدد نافذة Cutback محكومة.
أعد Routing وDNS والمراقبة التشغيلية إلى الوضع الطبيعي.
التعافي لا يكتمل حتى تتمكن المؤسسة من العودة بأمان إلى نموذج التشغيل الطبيعي.
14. قسّم الأحمال حسب درجة الأهمية#
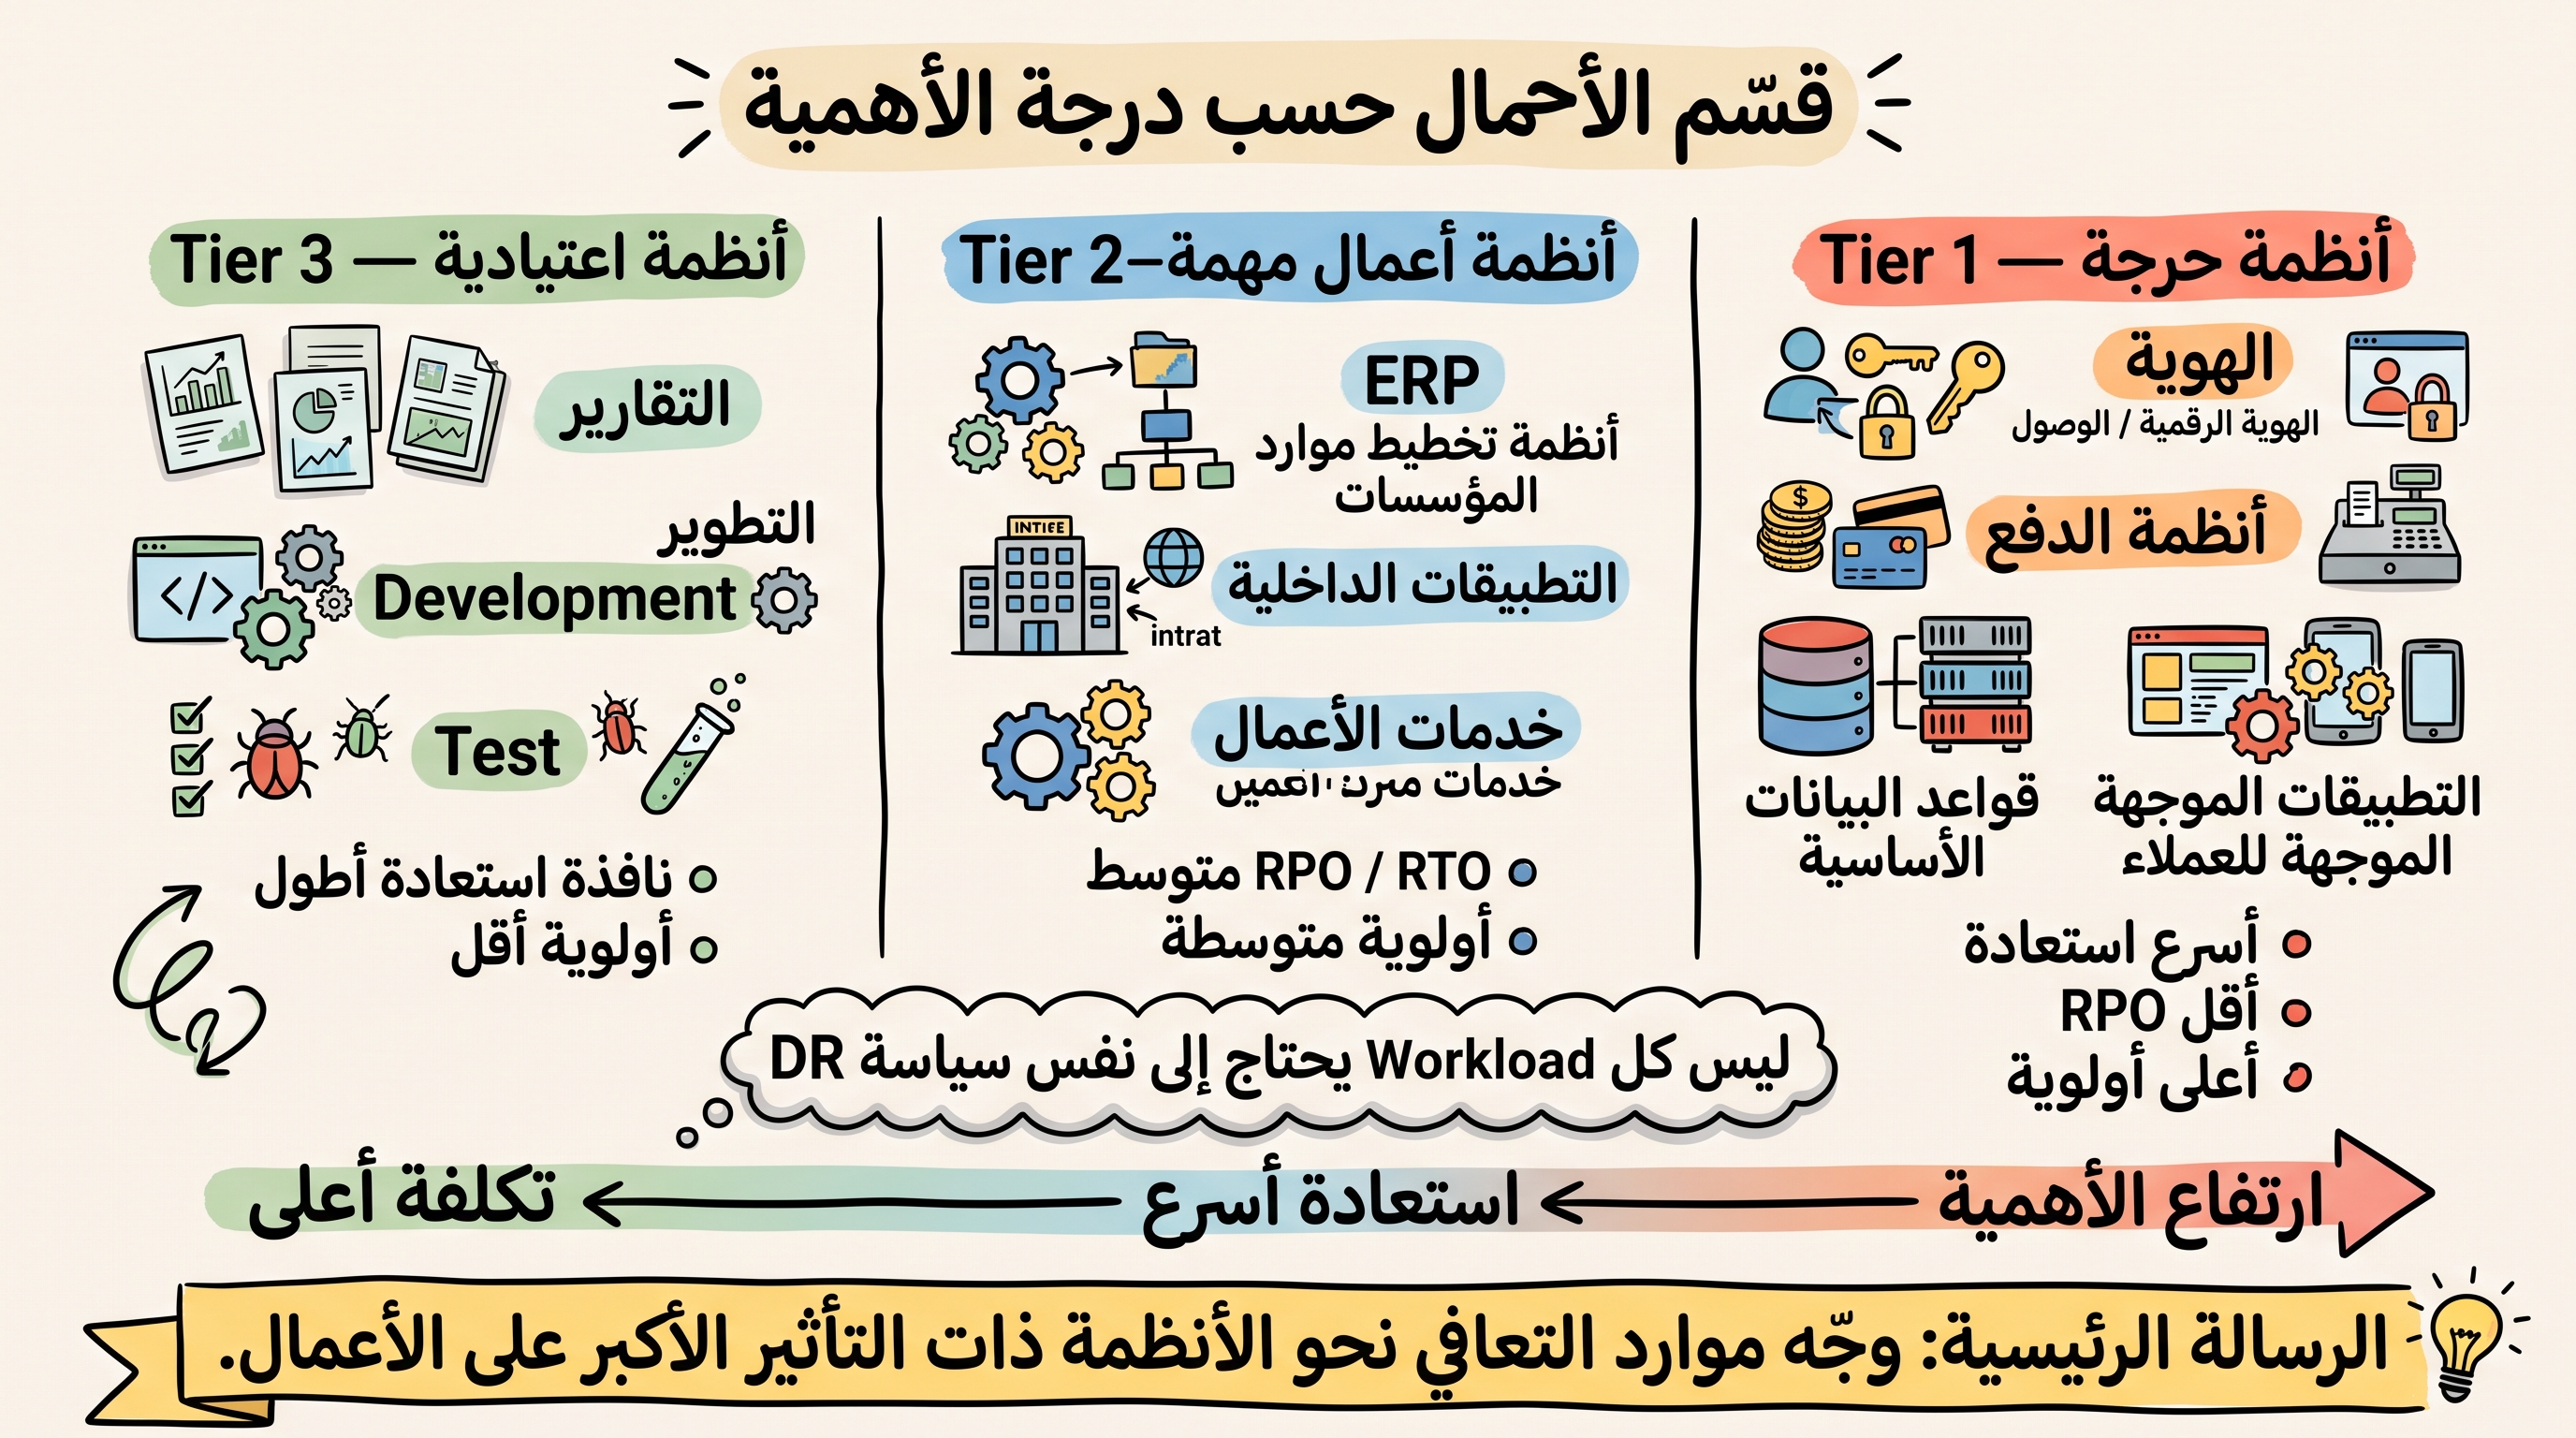
إعطاء جميع الأنظمة نفس RPO وRTO عادةً يؤدي إما إلى تكلفة زائدة أو حماية أقل من المطلوب للأنظمة الحرجة.
Tier 1: الهوية، وقواعد البيانات الأساسية، والدفع، والمعاملات، والخدمات الموجهة للعملاء.
Tier 2: تطبيقات الأعمال المهمة والخدمات الداخلية.
Tier 3: التقارير، والتطوير، والاختبار، والأنظمة الأقل أولوية.
عيّن لكل Tier أهداف RPO وRTO واحتفاظ وسياسات حوسبة مختلفة.
ليس كل Workload يحتاج إلى نفس سرعة التعافي أو نفس تكلفة DR.
15. قِس وراجع وحسّن باستمرار#
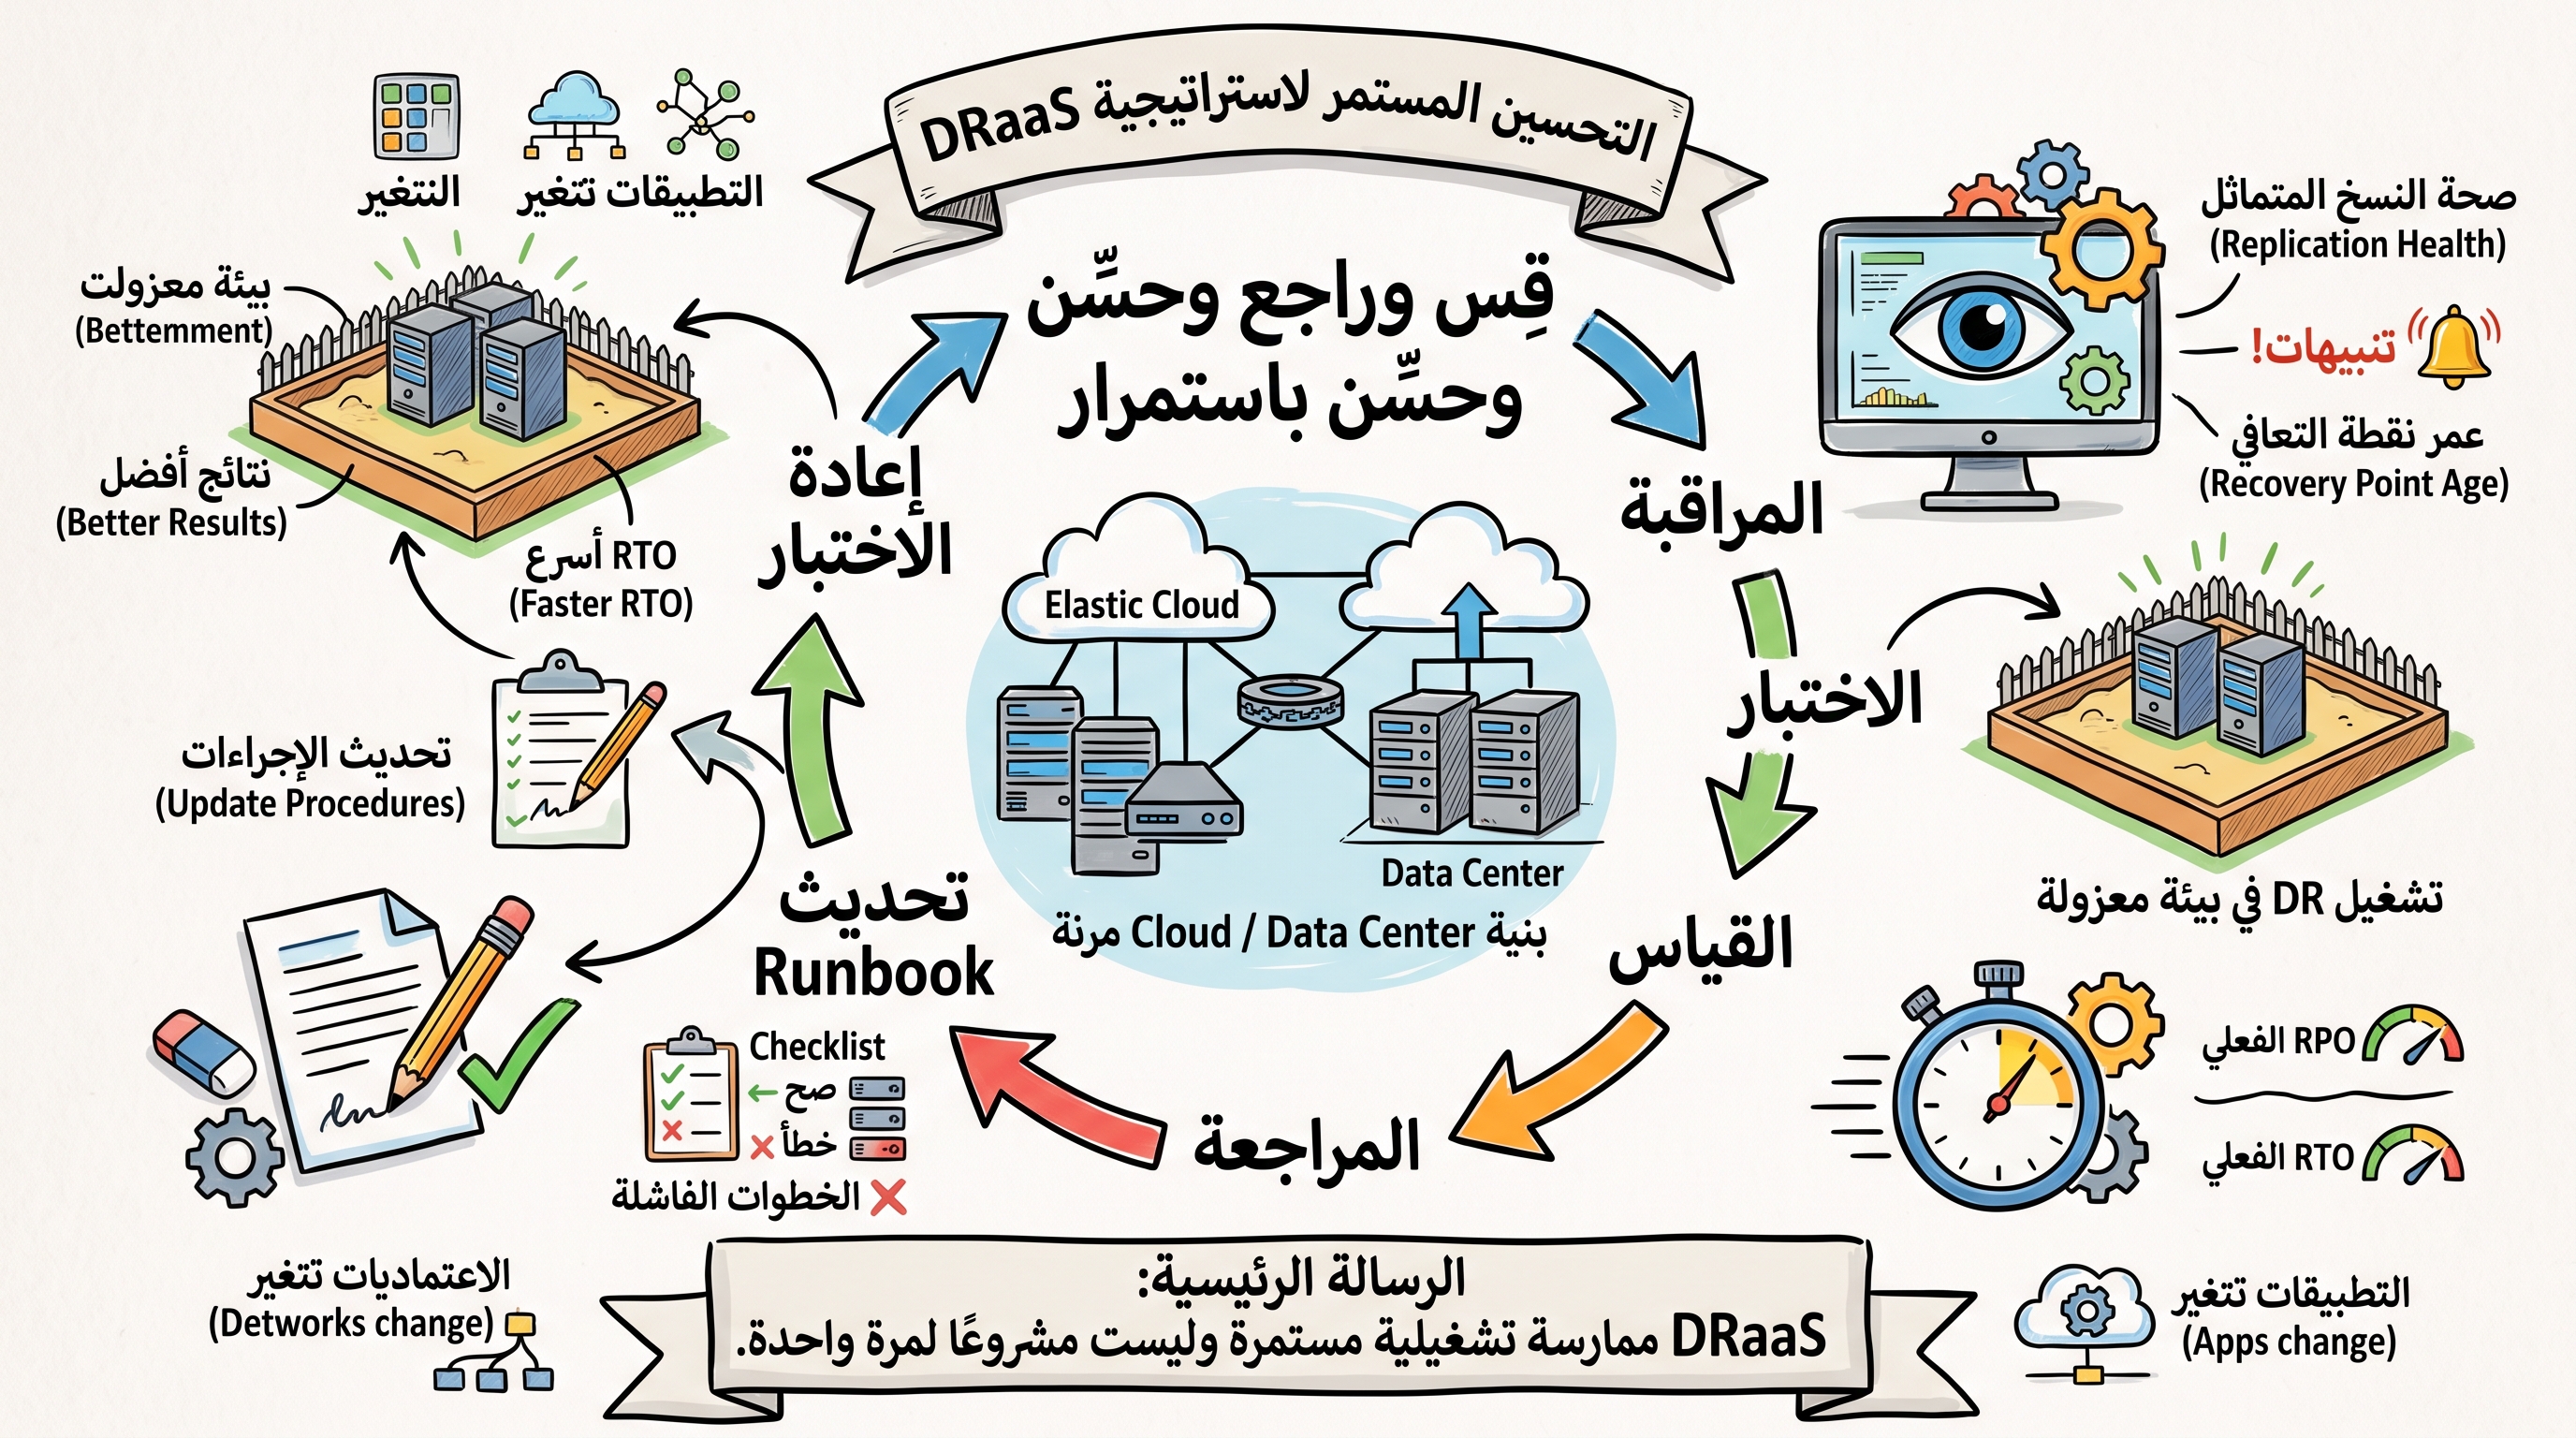
التطبيقات والشبكات والاعتماديات وأولويات الأعمال تتغير، ولذلك يجب أن تتغير خطة DR معها.
راقب صحة النسخ وعمر أحدث Recovery Point.
قِس RTO الفعلي في الاختبارات وقارنه بالهدف.
راجع الخطوات الفاشلة والاعتماديات اليدوية.
حدّث Runbooks بعد أي تغيير مهم في البنية أو التطبيقات.
أعد الاختبار بشكل دوري مع تطور البيئة.
DRaaS ممارسة تشغيلية مستمرة، وليس مشروعًا يُنفذ مرة واحدة.
أفضل سير عمل لـDRaaS#
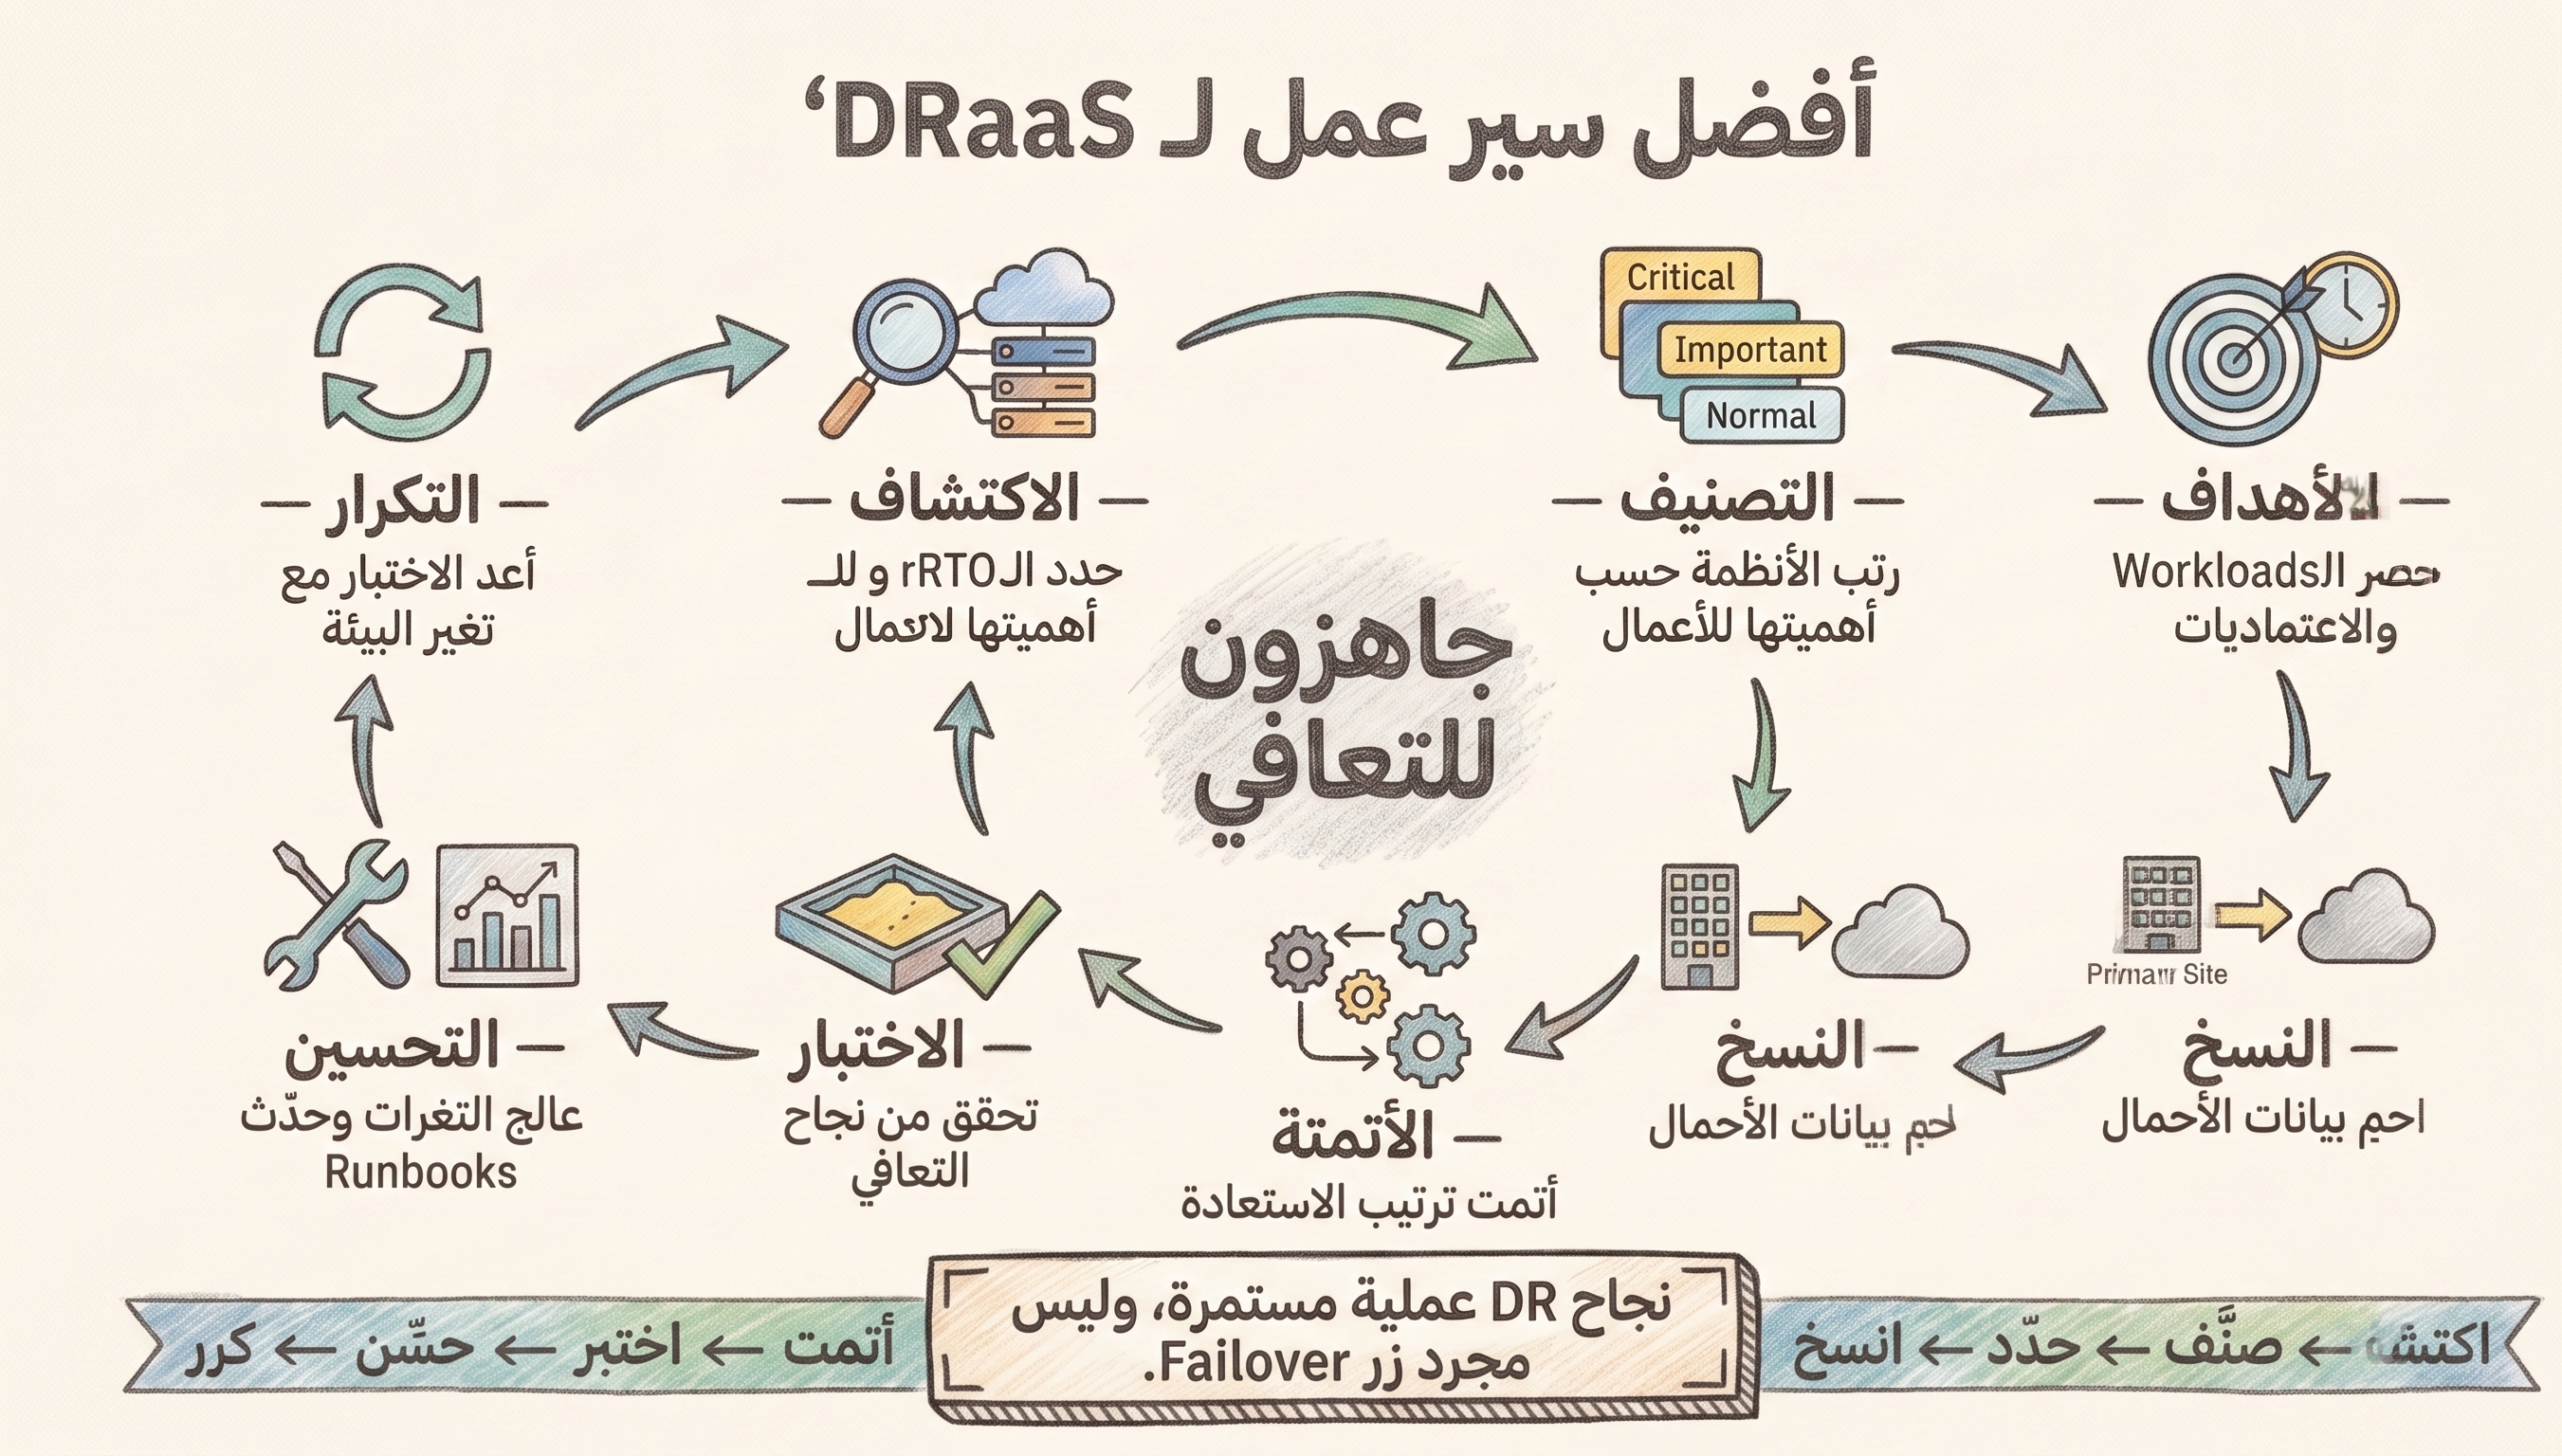
يمكن أن يكون سير العمل القوي للتعافي من الكوارث بسيطًا وواضحًا:
الخطوة 1 — الاكتشاف#
احصر الأحمال والاعتماديات والشبكات والمالكين وتأثير التوقف على الأعمال.
الخطوة 2 — التصنيف#
قسّم الأحمال إلى مستويات استعادة حسب الأهمية.
الخطوة 3 — تحديد الأهداف#
عيّن RPO وRTO لكل مستوى.
الخطوة 4 — النسخ المتماثل#
اختر نموذج النسخ، وموقع الهدف، وسياسة Recovery Points، وتصميم عرض النطاق.
الخطوة 5 — الأتمتة والتنظيم#
أنشئ Runbooks لترتيب التشغيل، والشبكات، والتحقق، والاتصالات، والموافقات.
الخطوة 6 — الاختبار#
استعد الأحمال داخل شبكات معزولة وقِس زمن التعافي الفعلي.
الخطوة 7 — التحسين#
عالج الخطوات الفاشلة، وأزل الاعتماديات اليدوية، وحدّث الوثائق.
الخطوة 8 — التكرار#
أعد الاختبار بعد أي تغييرات مهمة في التطبيقات أو البنية التحتية.
أهم حقيقة: DRaaS ليست مجرد منتج#
من الأخطاء الشائعة الاعتقاد بأن شراء منصة نسخ متماثل يعني تلقائيًا أن المؤسسة أصبحت تمتلك استراتيجية تعافٍ من الكوارث.
هذا غير صحيح.
المنصة ليست سوى جزء واحد من المنظومة.
القدرة الحقيقية هي أن تعرف ما الذي ستستعيده، وبأي ترتيب، وعلى أي شبكة، ومن أي نقطة استعادة، وخلال كم من الوقت، وكيف ستثبت أن العملية تعمل بالفعل.
التقنية تستطيع أتمتة النسخ والـFailover.
لكن المؤسسة لا تزال مسؤولة عن تعريف نموذج التشغيل والسياسات والإجراءات.
الخلاصة#
يوفر DRaaS الحديث مرونة أعلى في التعافي من خلال الجمع بين النسخ المستمر، والبنية السحابية، وإدارة Recovery Points، وأتمتة إجراءات الاستعادة.
لكن النتائج الأقوى لا تأتي من نشر منصة نسخ ثم انتظار الأفضل.
بل تأتي من عملية منضبطة:
افهم تأثير التوقف على الأعمال.
حدّد RPO وRTO.
استعد لأكثر من نوع واحد من الأعطال.
استخدم Backup وReplication معًا.
صمّم الشبكات والاعتماديات بعناية.
أتمت الـRunbook.
اختبر بانتظام.
خطط للـFailback.
واستمر في التحسين.
الهدف ليس فقط امتلاك نسخة ثانية من الـWorkloads.
الهدف هو أن تعرف بثقة أن العمل يستطيع الاستمرار عندما تصبح البيئة الأساسية غير متاحة.
هل أنت مستعد لتقييم استراتيجية التعافي لديك؟
ابدأ بتقييم أهمية الأحمال، وأهداف RPO وRTO الحالية، وتصميم النسخ، وشبكات التعافي، وآلية الاختبار، لبناء خارطة طريق DRaaS متوافقة مع المتطلبات التقنية ومتطلبات الأعمال.
تقييم المقال
كن أول من يقيّم هذا المقال
التعليقات والمناقشات0
مقالات ذات صلة
دليل مهندس البنية التحتية لخدمات الـ Co-Location: بين المتطلبات الهندسية وجدوى الانتقال  الحوسبة السحابية
دليل مهندس البنية التحتية لخدمات الـ Co-Location: بين المتطلبات الهندسية وجدوى الانتقال
نظرة هندسية واقعية حول استضافة عتاد الخوادم والشبكات في مراكز بيانات الـ Co-Location، تغطي معايير الطاقة والتبريد، الربط الشبكي وخطوط الـ Uplinks، بالإضافة إلى أفضل الممارسات الميدانية لإدارة الكبائن وضمان استمرارية الخدمة.
Emad Al-Hadheri